using TheoreticalComputerScienceTheoretische Informatik
Mathematics
Computer Science
Eine Zusammenfassung von Einführung in die Theoretische Informatik.
\[ \newcommand{\SIM}{\mathrm{SIM}} \newcommand{\LV}{\mathrm{LV}} \newcommand{\ZV}{\mathrm{ZV}} \newcommand{\ID}{\mathrm{ID}} \newcommand{\SUB}{\mathrm{SUB}} \newcommand{\PR}{\mathrm{PR}} \newcommand{\MIN}{\mathrm{MIN}} \newcommand{\pmd}{\mathrm{md}} \newcommand{\psum}{\mathrm{sum}} \newcommand{\pprod}{\mathrm{prod}} \newcommand{\pdiv}{\mathrm{div}} \newcommand{\pexp}{\mathrm{exp}} \]
About
Disclaimer: Diese Zusammenfassung ist nicht als Ersatz für die Vorlesung oder die Übung gedacht, sondern soll lediglich als Ergänzung dienen. Es ist möglich, dass Fehler enthalten sind. Bitte überprüft die Zusammenfassung sorgfältig und meldet eventuelle Fehler oder Unklarheiten an daniel.2.schwarzenbach@uni-konstanz.de.
https://daniel.schwarzenbach.dev/
Mochi Flashcards
Um sich effektiv auf die Prüfung vorzubereiten, empfehle ich die App Mochi: https://mochi.cards/
Ich habe dafür eine Sammlung von Flashcards erstellt, die die wichtigsten Konzepte abdecken sollte: Download Flashcards
TheoreticalComputerScience.jl
Für Theoretische Informatik gibt es ein Julia-Package, das die meisten der in der Vorlesung behandelten Konzepte implementiert.
Install Julia: https://julialang.org/downloads/
Github Repo: https://github.com/daniel-schwarzenbach/TheoreticalComputerScience.jl
Es ist auf GitHub verfügbar und kann mit dem folgenden Befehl installiert werden:
using Pkg
Pkg.add(url="https://github.com/daniel-schwarzenbach/TheoreticalComputerScience.jl")
um es zu verwenden, können Sie es einfach importieren:
References
Aufbauend auf der Vorlesung von Prof. Dr. Sven Kosub, Konstanz, Sommersemester 2026.
Kahoot!
Für die Übungen erstelle ich Kahoot!-Quizzes, um die wichtigsten Konzepte zu überprüfen.
Kahoot Nr.1
- Wörter
- Sprachen
- Codierungen
- Hüllen Operatoren
Kahoot Nr.2
- RAM
- Algebraische Erzeugung von Funktionen
- \(\textbf{FUNK}\)
https://create.kahoot.it/share/ti2-funk-ram/02b7c3d5-3dbd-4e3c-b125-6b22cc196de0
Kahoot Nr.3
- Turingmaschinen
https://create.kahoot.it/share/ti3-turingmaschinen/ca3dc653-d9e9-416c-a3d8-b2d38bec5482
Kahoot Nr.4
- Turingmaschinen (wiederholung)
- Algebraische Erzeugung von Funktionen (wiederholung)
- Partiell rekursive Funktionen
https://create.kahoot.it/share/ti4-prim/b51cccae-b85e-45aa-ae69-befbd21aa05c
Kahoot Nr.5
- PRIM
https://create.kahoot.it/share/ti5-part/5b801a03-7b3e-41c9-89bf-3616bd8624d6
Kahoot Nr.6
- Entscheidbarkeit
- Aufzählbarkeit
https://create.kahoot.it/share/ti6/e0764dd0-19e0-4698-b97c-04ebcf5dfe1c
Kahoot Nr.7
- Unentscheidbare Mengen
- many-to-one Reduktion
- Satz von Rice
https://create.kahoot.it/share/ti7/07363b0e-148b-4ec9-b2bc-e2b82a30c3a2
Kahoot Nr.8
- Laufzeit von Algorithmen
- Die Klasse \(\textbf{P}\)
https://create.kahoot.it/share/ti8/e24b58cf-e922-4981-ae41-0ece5cef47f2
Kahoot Nr.9
- Nichtdeterministische Maschienen
- Die Klasse \(\textbf{NP}\)
https://create.kahoot.it/share/ti9/684df261-8e90-4889-adb2-b387989fbee8
Kahoot Nr.10
- NP-Vollständigkeit
- \(≤_m^p\)-Reduktionen
https://create.kahoot.it/share/ti10/f9abf091-9933-4e79-8c76-77993994ee9a
Kahoot Nr.11
- \(≤_m^p\)-Reduktionen
- Endliche Automaten
- Reguläre Mengen
https://create.kahoot.it/share/ti11/fb6381fc-e727-4945-b901-58ed20462ae8
Kahoot Nr.12
- Reguläre Sprachen
- Pumping Lemma für reguläre Sprachen
- rechtslineare Grammatiken
https://create.kahoot.it/share/ti12/d863e913-b842-4484-b494-e96ad6c1076b
Kahoot Nr.13
- EA → REG algorithmus
- Chomsky Hierarchie
- Kontextfreie Sprachen
- Chomsky Normalform
- Pumping Lemma für kontextfreie Sprachen
https://create.kahoot.it/share/ti13/18e3f518-ea92-4fe8-94dd-c943484b8a27
Prüfungsquiz
https://create.kahoot.it/share/ti-prufungsquiz/2671a721-9184-4fc5-a5ca-e24c6d3c764f
Mathematische Grundlagen
Wörter und Sprachen
Sei \(Σ\) eine endliche nichtleere Menge von Zeichen/Characters
- \(Σ\) heißt Alphabet
- Elemente von \(Σ\) heißen Symbole, Buchstaben, Zeichen
- ein Wort x(über \(Σ\)) ist eine endliche Aneinanderreihung von Buchstaben
- \(|x|\) bezeichnet Länge von \(x\)
- \(|x|ₐ\) bezeichnet die Anzahl des Vorkommens von \(a ∈ Σ\) in \(x\)
- \(ε\) ist das leere Wort
- \(Σ^*\) ist die Menge aller Wörter über \(Σ\)
- \(Σ^+\) := \(Σ^* ∖ \{ε\}\)
- Eine Menge \(L ⊆ Σ^*\) heisst formale Sprache über \(Σ\)
Beispiel:
- \(Σ = \{a, b\}\), \(x = aababb\), \(|x| = 6\), \(|x|_a = 3\), \(|x|_b = 3\)
Operationen auf Wörtern
Seien \(x = a_1 ... a_n, \quad y = b_1 ... b_n\) zwei Wörter
- Konkatenation: \(xy = a_1a_2...a_nb_1b_2...b_n\)
- Spiegelwort: \(x^R = a_na_{n-1}...a_1\)
- Potenz: \(x^0 = ε\), \(x^k = x^{k-1}x\)
Beispiel:
- \(Σ = \{a, b\}\), \(x = aababb\), \(y = ab\), \(xy = aababbab\), \(x^R = bbabaa\), \(x^3 = aababbaababbaababb\)
Operationen auf Sprachen
- konkatenation: \(L⋅L' = \{xy ∣ x ∈ L, y ∈ L'\}\)
- iteration
- \(L^0 = \{ε\}\)
- \(L^k = L^{k-1}L\)
- \(L^* = ⋃_{k ∈ ℕ} L^k\)
- \(L^+ = ⋃_{k ∈ ℕ₊} L^k\)
Insbesondere gilt: \(\{x\}^k = \{x^k\} \quad ∀x ∈ Σ^*, \; k ≥ 0\)
Beispiel:
- \(Σ = \{a, b\}\), \(L = \{a, ab\}\), \(L^2 = \{aa, aab, aba, abab\}\), \(L^* = \{ε, a, ab, aa, aab, aba, abab,...\}\)
Kodierung von Zahlen
Unär
- \(\text{un} : ℕ → \{a\}^*\)
- \(n ↦ a^ⁿ\)
- ist bijektiv
- \(\text{un}(5) = \textit{IIIII}\)
Dezimal
- \(\text{dec}: ℕ → \{\textit{0,1,...,9}\}^*\)
- \(\text{dec}(0) = \textit{0}\)
- \(\text{dec}(n) = a_ma_{m-1}...a_1a_0\)
- \(\text{dec}\) ist injektiv aber nicht surjektiv
\(\text{dec}(18) = \textit{18}\)
Binär
- \(\text{bin}: ℕ → \{\textit{0,1}\}^*\)
- \(\text{bin}(0) = 0\)
- \(\text{bin}(n) = a_ma_{m-1}...a_1a_0\)
- \(\text{bin}\) ist injektiv aber nicht surjektiv
\(\text{bin}(18) = \textit{1'0010}\)
k-adisch
- \(\text{ad}_k: ℕ → \{\textit{1,...,k}\}^*\)
- \(\text{ad}_k(0) = ε\)
- \(\text{ad}_k(n) = a_ma_{m-1}...a_1a_0\)
- \(\text{ad}_k\) ist bijektiv
Dyadische Codierung
dyadisch: \(\text{dya} := \text{ad}_2\)
| dec(n) | dya(n) | bin(n) | \(\text{ad}_3(n)\) |
|---|---|---|---|
| 0 | ε | 0 | ε |
| 1 | 1 | 1 | 1 |
| 2 | 2 | 10 | 2 |
| 3 | 11 | 11 | 3 |
| 4 | 12 | 100 | 11 |
| 5 | 21 | 101 | 12 |
| 6 | 22 | 110 | 13 |
| 7 | 111 | 111 | 21 |
| 8 | 112 | 1000 | 22 |
Die dyadische Kodierung natürlicher Zahlen ist die wie folgt rekursiv definierte, bijektive Abbildung \(\text{dya}: ℕ → \{\textit{1,2}\}^*\):
\[ \text{dya}(n) = \begin{cases} ε & \text{falls } n = 0 \\ \text{dya}(\frac{n-2}{2}) \textit{2} & \text{falls } n > 0 \text{ und gerade} \\ \text{dya}(\frac{n-1}{2}) \textit{1} & \text{falls } n \text{ ungerade} \\ \end{cases} \]
Die Umkehrfunktion \(\text{dya}^{-1} : \{\textit{1,2}\}^* → ℕ\) ist wie folgt definiert:
\[ \text{dya}^{-1}(a_{n-1}, ..., a_{0}) = \sum_{i = 0}^{n-1} a_i ⋅ 2^i \]
Anmerkung:
\[ \text{dya}(2^n - 1) = {\textit{1}}^n = \text{bin}(2^n - 1) \]
Als julia-Funktion könnte die dyadische Kodierung wie folgt implementiert werden:
function dya(n::Integer)::String
  if n == 0
    return ""
  elseif n % 2 == 0
    return dya((n-2) ÷ 2) * "2"
  else
    return dya((n-1) ÷ 2) * "1"
  end
end
function dya⁻¹(str::String)::Integer
n = 0 # resultat
i = 0 # laufindex
for c ∈ reverse(str)
if c == '1'
n += 2^i
elseif c == '2'
n += 2 * 2^i
end
i += 1
end
return n
end
Note
Das TheoreticalComputerScience.jl Package enthält Implementierungen der dyadischen Kodierung.
@show dya⁻¹("11211")
@show dya⁻¹("2222212122")
@show dya(420)
nothing # remove output
dya⁻¹("11211") = 35
dya⁻¹("2222212122") = 2026
dya(420) = "21211212"Hüllenoperator
Sei A eine Menge. Eine totale Funktion \(Γ:\mathcal{P}(A) → \mathcal{P}(A)\) heißt Hüllenoperator über A, falls folgende Bedingungen gelten:
- Einbettung: \(B ⊆ Γ(B)\) für alle \(B ⊆ A\)
- Monotonie: \(B ⊆ C ⇒ Γ(B) ⊆ Γ(C)\) für alle \(B,C ⊆ A\)
- Abgeschlossenheit: \(Γ(Γ(B)) ⊆ Γ(B)\)
Beispiel:
Für \(A = ℕ\) und \(|\)(Teilbarkeit) ist \(Γ(B) = \{n ∣ \text{es gibt } m ∈ B \text{ mit } n|m\}\) ein Hüllenoperator. Insbesondere gilt:
- \(Γ(\{ 0 \}) = ℕ\)
- \(Γ(\{24\}) = \{1,2,3,4,6,12,24\}\)
- \(Γ(\{13\}) = \{1, 13\}\)
Ein Hüllenoperator \(Γ: \mathcal{P}(A) → \mathcal{P}(A)\) heißt algebraisch, falls gilt:
Für alle \(B ⊆ A\) und für alle \(b ∈ Γ(B)\) gibt es endliches \(B_0 ⊆ B\) mit \(b ∈ Γ(B_0)\)
Beispiel:
Definiere \(Γ:\mathcal{P}(ℕ) → \mathcal{P}(ℕ)\) wie folgt:
\[ Γ(B) = \begin{cases} B & \text{falls } |B| < \infty \\ ℕ & \text{sonst} \end{cases} \]
Dann ist \(Γ\) ein Hüllenoperator. Es gilt \(Γ(ℕ_+) = ℕ, \; 0 ∈ Γ(ℕ_+)\)
aber: \(0 ∉ Γ(B_0) = B_0\) für endliche \(B_0 ⊆ ℕ_+\)
Abgeschlossenheit unter Operation \(O\)
Ein Funktion \(O: A^s → A\) heißt \(s\)-stellige Operation auf \(A\).
Sei \(O: A^s → A\) eine \(s\)-stellige Operation auf \(A\). Eine Menge \(C ⊆ A\) heißt abgeschlossen unter \(O\) falls gilt: \[a_1,...,a_s ∈ C \quad ⇒ \quad O(a_1,...,a_s) ∈ C\]
Seien \(O_i: A^{s_i} → A\) für \(i ∈ \{1,...,k\}\) Operationen auf \(A\), \(B ⊆ A\). Dann ist \(Γ_{O_1,...,O_k}(B)\) die kleinste Menge, die \(B ⊆ A\) enthält und abgeschlossen ist unter \(O_1,...,O_k\) d.h.
\[Γ_{O_1,..,O_k} (B) = ⋂ \{C ∣ B ⊆ C, \; C \text{ abgeschlossen unter } O_1, ..., O_k\}\] \(Γ_{O_1,..,O_k}\) heisst der durch \(O_1,...,O_k\) erzeugte Hüllenoperator.
Beispiel:
- \(Γ_{\text{sum}}(\{1\}) = ℕ_+\) da \(1+1=2, 1+2=3, 2+2=4,...\)
- \(Γ_{\text{prod}}(\{1\}) = \{1\}\) da \(1⋅1=1\)
- \(Γ_{\text{sum,prod}}(\{2, 3\}) = \{x∈ℕ ∣ x = 2^a ⋅ 3^b \text{ mit } a+b ≥ 1\}\)
Anmerkung:
\(Γ_{O_1,..,O_k}\) ist ein algebraischer Hüllenoperator.
Beispiel für einen Hüllenoperator: Hasse-Diagramm
Betrachten Sie den folgenden gerichteten Graphen \(([6], R_0)\) der das Hasse-Diagramm einer Halbordnung \(⪯_a\) darstellt:

Es gilt nun: \(1 ⪯_a 6\), \(2 \not ⪯_a 4\) und \(3 ⪯_a 3\).
Ein Hasse-Diagramm enthält bereits die komplette Information über die Halbordnung. Mithin ist die Halbordnung \(⪯_a\) gegeben durch die Reflexive und Transitive Hülle der Relation \(R_0\). Das heißt, \[ Γ_{\text{reflexiv, transitiv}}(R_0) \; = \; ⪯_a \]
Der Grund warum wir für Halbordnungen Hasse-Diagramme angeben ist, dass sie viel kleiner und lesbarer sind als einer Graph einer Halbordnung.
Man betrachte den Graphen \(([6], Γ_{\text{reflexiv, transitiv}}(R_0))\):

Aufgabe: Konvexe Hülle
- Zeit: 8 Minuten
Sie haben in der Vorlesung bereits die konvexe Hülle von Punkten kennengelernt. Sei \(B ⊆ ℝ^n\) eine endliche Menge von Punkten mit \(|B|>1\).
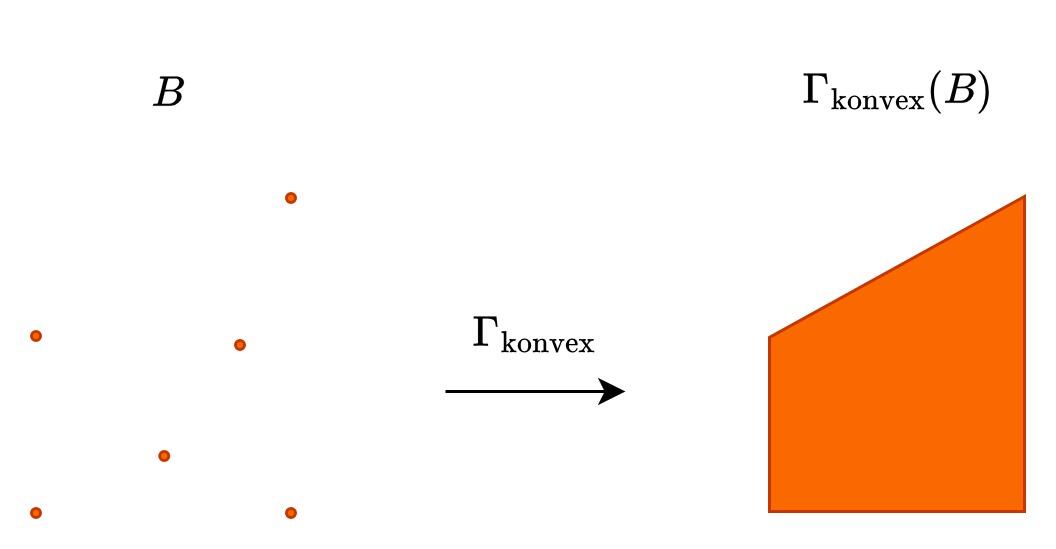
- Definiern Sie den Konvexen Hüllenoperator \(Γ_{\text{konvex}}(B)\) formal korrekt.
- Können sie Operatoren \(O_1,...,O_k\) finden sodass \(\Gamma_{\text{konvex}} = \Gamma_{O_1,...,O_k}\)? Wenn ja, geben Sie die Operationen an. Wenn nein, begründen Sie warum nicht.
Algebraische Erzeugung von Funktionen
Operationen auf \(ℕ\)
Wir definieren die folgenden Operatoren \(ℕ²\to ℕ\):
\[\text{sum}(x,y) = x+y\]
\[ \text{md}(x,y) = x ∸ y = \begin{cases} x-y & \text{falls } x > y \\ 0 & \text{sonst} \end{cases} \]
\[\text{prod}(x,y) = x⋅y\]
\[\text{div}(x,y) = \begin{cases} \left\lfloor \frac{x}{y} \right\rfloor & \text{ falls } y > 0 \\ x & \text{ falls } y = 0 \end{cases} \]
\[\exp(x,y) = x^y\]
Weitere Operationen die wir definieren sind:
- Increment:
- \(\text{S}: ℕ → ℕ\)
- \(\text{S}(x) = x + 1\)
- Projektion/Identität:
- \(\text{I}^n_i: ℕ^n → ℕ\)
- \(\text{I}^n_i(x_1, ..., x_n) = x_i\)
- Konstante:
- \(\text{C}^n_c: ℕ^n → ℕ\)
- \(\text{C}^n_c(x_1, ..., x_n) = c\)
Operatoren auf \(\textbf{FUNK}(A)\)
Sei A eine beliebige Menge. Definiere dann die Menge der Operationen auf A als: \[\textbf{FUNK}(A) := \{φ ∣ ∃ n∈ℕ \text{ mit } φ: A^n → A\}\]
\(\textbf{FUNK}(ℕ)\) ist für die Theoretische Informatik von fundamentaler Bedeutung. Unter anderem ist \(\textbf{TM} ⊆ \textbf{FUNK}(ℕ)\).
Es seien \(φ: A^n → A, \; ψ:A^m → A \quad \in \textbf{FUNK}(A)\)
- zyklische Vertauschung:
- \(\text{ZV}(φ): A^n → A\)
- \(\text{ZV}(φ)(x_1,...,x_n) = φ(x_2,...,x_n,x_1)\)
- vertauschung der letzten Variable:
- \(\text{LV}(φ): A^n → A\)
- \(\text{LV}(φ)(x_1,...,x_n) = φ(x_1,...,x_{n-2},x_n,x_{n-1})\)
- Identifikation der letzten Variablen:
- \(\text{ID}(φ): A^{n-1} → A\)
- \(\text{ID}(φ)(x_1,...,x_{n-1}) = φ(x_1,...,x_{n-1},x_{n-1})\)
- Substitution an letzter Stelle:
- \(\text{SUB}(φ, ψ): A^{n-1+m} → A\)
- \(\text{SUB}(φ, ψ)(x_1,...,x_{n-1},y_1,...,y_m) = φ(x_1,...,x_{n-1}, ψ(y_1,...,y_m))\)
Beispiel:
\[ \begin{aligned} \text{ID}(\text{ZV}(\text{ZV}(\text{SUB}(\text{sum},\text{md})))) (x,y) & = \text{ZV}(\text{ZV}(\text{SUB}(\text{sum},\text{md}))) (x,y,y) \\ & = \text{ZV}(\text{SUB}(\text{sum},\text{md})) (y,y,x) \\ & = \text{SUB}(\text{sum},\text{md}) (y,x,y) \\ & = \text{sum}(y,\text{md}(x,y)) \\ & = y + (x ∸ y) \\ & = \max\{x,y\} \end{aligned} \]
mithin gilt dann:
\[ \max ∈ Γ_{\text{ZV}, \text{ID}, \text{SUB}}(\{\text{sum}, \text{md}\}) \]
Sei \(A ⊆ ℕ\) und \(ψ,φ,ρ_1,...,ρ_n ∈ \textbf{FUNK}(A)\).
\(ψ\) ist durch Permutation der Variablen aus \(φ\) erzeugt, falls eine permutation \(π\) existiert mit \[ ψ(x_1,...,x_n) = φ(x_{π(1)},...,x_{π(n)}) \]
\(ψ\) ist durch Identifikation von Variablen aus \(φ\) erzeugt, falls \(i,j\) mit \(1≤i≤j≤n\) gibt, mit \[ ψ(x_1,...,x_{j-1},x_{j+1},...,x_n) = φ(x_1,...,x_{j-1},x_i,x_{j+1},...,x_n) \]
\(ψ\) ist durch simultane Substitution von \(ρ_1,...,ρ_n\) in \(φ\) erzeugt, falls \[ ψ(x_1,...,x_m) = φ(ρ_1(x_1,...,x_m), ..., ρ_n(x_1,...,x_m)) \]
Daraus definieren wir den Operator \(\SIM\):
\[ \SIM_n: (ℕ^n → ℕ) × (ℕ^m → ℕ)^n → (ℕ^m → ℕ) \]
\[ \text{SIM}_n(φ, ψ_1,...,ψ_n)(x_1, ..., x_m) = φ(ψ_1(x_1,...,x_m), ..., ψ_n(x_1,...,x_m)) \]
Ist die Funktion \(ψ\) durch Permutation der Variablen aus \(φ\) entstanden, so gilt: \(ψ ∈ Γ_{\text{ZV},\text{LV}}(\{φ\})\).
Ist die Funktion \(ψ\) durch Identifikation von Variablen aus \(φ\) entstanden, so gilt: \(ψ ∈ Γ_{\text{ID},\text{ZV},\text{LV}}(\{φ\})\).
Ist die Funktion \(ψ\) durch simultane Substitution von \(\rho_1,...,\rho_n\) in \(φ\) erzeugt, so gilt: \(ψ ∈ Γ_{\text{SUB},\text{ZV},\text{ID},\text{LV}}(\{φ,\rho_1,...,\rho_n\})\).
Algorithmentheorie
Random-Access-Maschinen
- Die Steuereinheit enthält das Programm und führt es aus. Ein Programm besteht aus einer endlichen Liste von nummerierten Befehlen.
- Das Befehlsregister enthält die Nummer des aktuellen Befehls im Programm.
- Jedes der unendlich vielen (Daten-)Register
R0, R1, R2, ...enthält eine natürliche Zahl (gespeichert in dyadischer Darstellung). Die Nummerivon RegisterRiheißt Adresse.
Bezeichnungen:
<Ri>      # inhalt von Ri, d.h. R[i]
<BR>     # inhalt von BR ≃ *BR
<R> := x # Register R bekommt neuen Inhalt x, dh
Befehle, Wirkung
# Transportbefehle
Ri ← Rj     # <Ri> := <Rj>
Ri ← RRj    # <Ri> := <R<Rj>>
RRi ← Rj    # R[R[i]] := R[j]
# Arithmetische Befehle
Ri ← k         # R[i] = k
Ri ← Rj + Rk   # R[i] =  R[j] + R[k]
Ri ← Rj - Rk   # R[i] =  R[j] - R[k]
# Sprungbefehle
IF Rj = 0 THEN GOTO x  # falls <Rj> = 0, dann gehe zu Befehl mit Nummer x
IF Rj > 0 THEN GOTO x  # falls <Rj> > 0, dann gehe zu Befehl mit Nummer x
GOTO x                 # gehe zu Befehl mit Nummer x
RAM-Emulieren
z.B. Die Funktion \(f(x,y,z) = x + y - z\) könnte durch folgendes RAM-Programm berechnet werden:
./test.ram:
# f(x,y,z) = x + y - z
# R0 = x, R1 = y, R2 = z
0   R0 ← R0 + R1
1   R0 ← R0 - R2
2   STOP
Wir können ein RAM-Programm mit dem Julia-Package TheoreticalComputerScience.jl ausführen:
# Make sure to set all registers needed by the RAM program
set_registers!([9, 2, 8])
# Execute the RAM program
execute_ramfile("./test.ram")
R = [9, 2, 8]
0: R0 ← R0 + R1 ⟹ R = [11, 2, 8]
1: R0 ← R0 - R2 ⟹ R = [3, 2, 8]
2: STOP ⟹ Final register state: [3, 2, 8]
Alternativ kann das RAM-Programm auch direkt in Julia eingeben:
set_registers!([8, 4, 11])
execute_ramcode([
 # f(x,y,z) = x + y - z
 "R0 <- R0 + R1", # 0
 "R0 ← R0 - R2", # 1
 "STOP" # 2
])
R = [8, 4, 11]
0: R0 <- R0 + R1 ⟹ R = [12, 4, 11]
1: R0 <- R0 - R2 ⟹ R = [1, 4, 11]
2: STOP ⟹ Final register state: [1, 4, 11]
Höhere Programmiersprachen
\(\textbf{RAM} ⊆ \textbf{Julia}\), schliesslich können wir ja auch RAM code in Julia emulieren.
Aber es gilt auch \(\textbf{Julia} ⊆ \textbf{RAM}\). Julia wird explizit compiliert in x64 Assembler, was dann in ein RAM-Programm übersetzt werden kann, d.h. es gibt einen Algorithmus, der jedes Julia-Programm in ein RAM-Programm übersetzt.
ergo: Julia ist Turing-vollständig.
Turingmaschinen
Definition: Turingmaschinen
Eine Turingmaschine mit \(k\)-Bändern ist ein Tupel \(M = (Σ, Z, f, z₀, z_1)\) bestehend aus:
- einem Bandalphabet \(Σ\),
- eine Menge von Zuständen \(Z\),
- einer Überführungsfunktion \(f : Z × Σ^k \; → \; Z × Σ^k × \{L, 0, R\}^k\),
- einem Startzustand \(z₀ ∈ Z\),
- einem Endzustand \(z_1 ∈ Z\).
Eine Turingmaschine besteht aus folgenden Komponenten:
- \(k\) (mit \(k ≥ 1\)) beidseitig unendliche, in Zellen unterteilte Bänder; in jeder Zelle steht genau ein Symbol aus dem Bandalphabet \(Σ\), wobei das Leerzeichen \(□ ∈ Σ\) zeigt an, dass in der Zelle eigentlich nichts steht
- für jedes Band ein Schreib- und Lesekopf (oder kurz einfach Kopf), der sich von Zelle zu Zelle bewegen kann, um Inhalte der Zellen zu lesen und zu verändern
- eine Steuereinheit, die sich in einem Zustand \(z\) aus einer endlichen Zustandsmenge \(Z\) befindet, die über die Köpfe Bandinhalte liest und die Aktivitäten entsprechend steuert
das Verhalten pro Takt wird durch eine (totale) Überführungsfunktion: \[ f : Z × Σ^k \quad → \quad Z × Σ^k × \{L, 0, R\}^k \] beschrieben; die Beschreibung ist unabhängig von Taktnummer und Kopfpositionen.
Definition: Turing-Berechenbarkeit
- Seien \(M = (Σ, Z, f, z_0, z_1)\) eine Turingmaschine, \(Σ_1 ⊆ Σ ∖ \{□,*\}, Σ_2 ⊆ Σ ∖ \{□\}, n ∈ N\). Eine Funktion \(ψ : (Σ^∗_1)^n → Σ^∗_2\) heißt von der Turingmaschine \(M\) berechnet, falls für alle \(x_1, ... , x_n ∈ Σ^*_1\) gilt:
Ist \(ψ(x_1, ... , x_n)\) definiert, so gilt: Startet \(M\) in \(S(z_0, x_1 ∗ x_2 ∗ ··· ∗ x_n)\), so stoppt \(M\) in \(S(z_1, ψ(x_1, ..., x_n))\).
Ist \(ψ(x_1, ... , x_n)\) nicht definiert, so gilt: Startet \(M\) in \(S(z_0, x_1∗x_2∗···∗x_n)\), so stoppt \(M\) nicht oder \(M\) stoppt aber nicht in einer Situation der Form \(S(z_1, y)\) mit \(y ∈ (Σ ∖ \{□\})^*\).
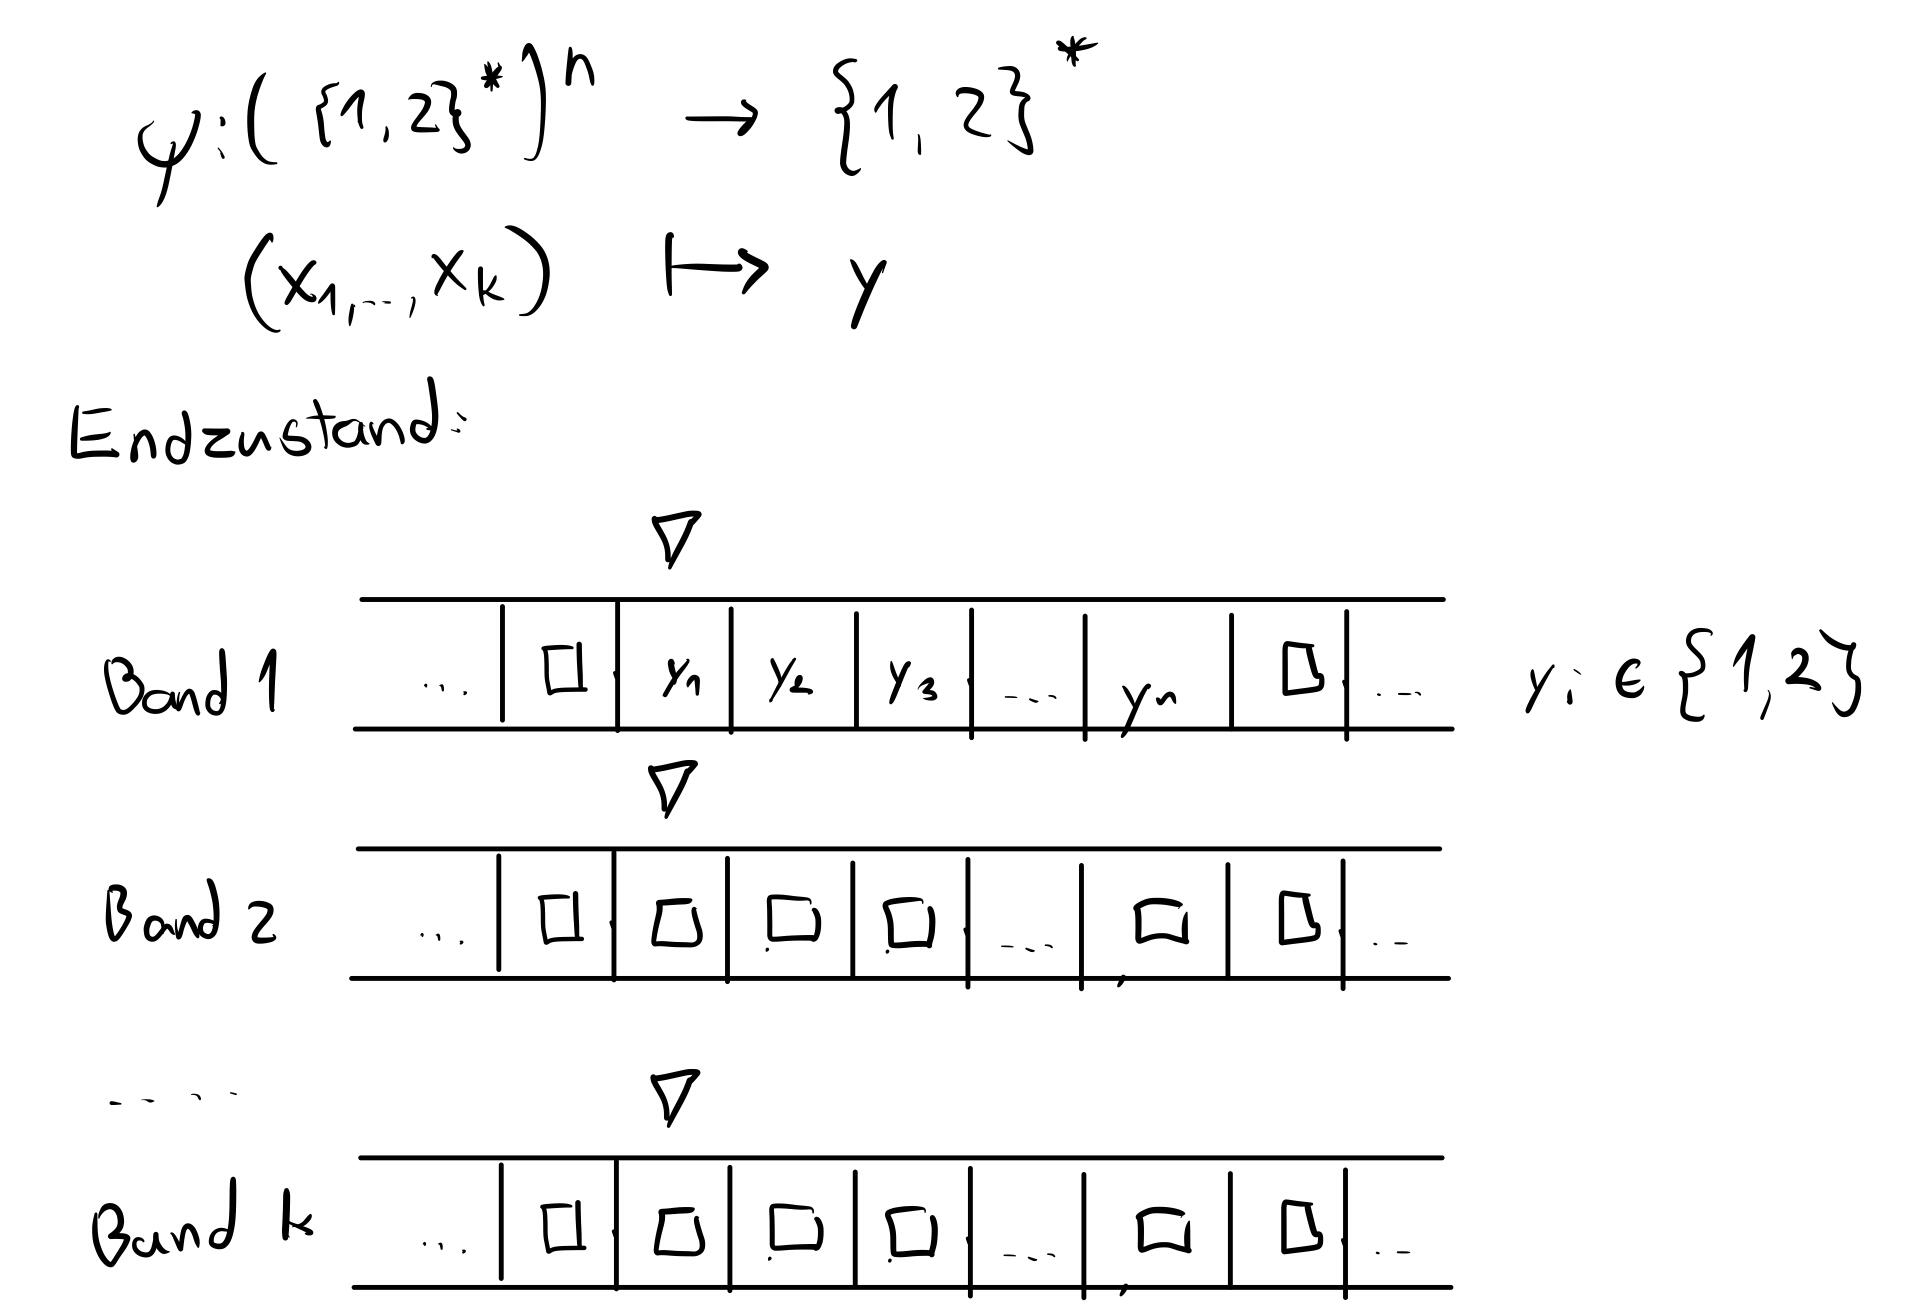
Eine Funktion \(ψ : (Σ^*_1)^n → Σ^*_2\) heißt Turing-berechenbar, falls es eine Turingmaschine gibt, die \(ψ\) berechnet.
Eine Funktion \(φ : ℕ^n → ℕ\) heißt Turing-berechenbar, falls sie in dyadischer Kodierung Turing-berechenbar ist, d.h. falls die durch \(ψ(x_1, ... , x_n) = \text{dya}(φ(\text{dya}^{-1}(x_1), ..., \text{dya}^{-1}(x_n)))\) definierte Funktion \(ψ : (\{1, 2\}^∗)^n → \{1, 2\}^*\) Turing-berechenbar ist.
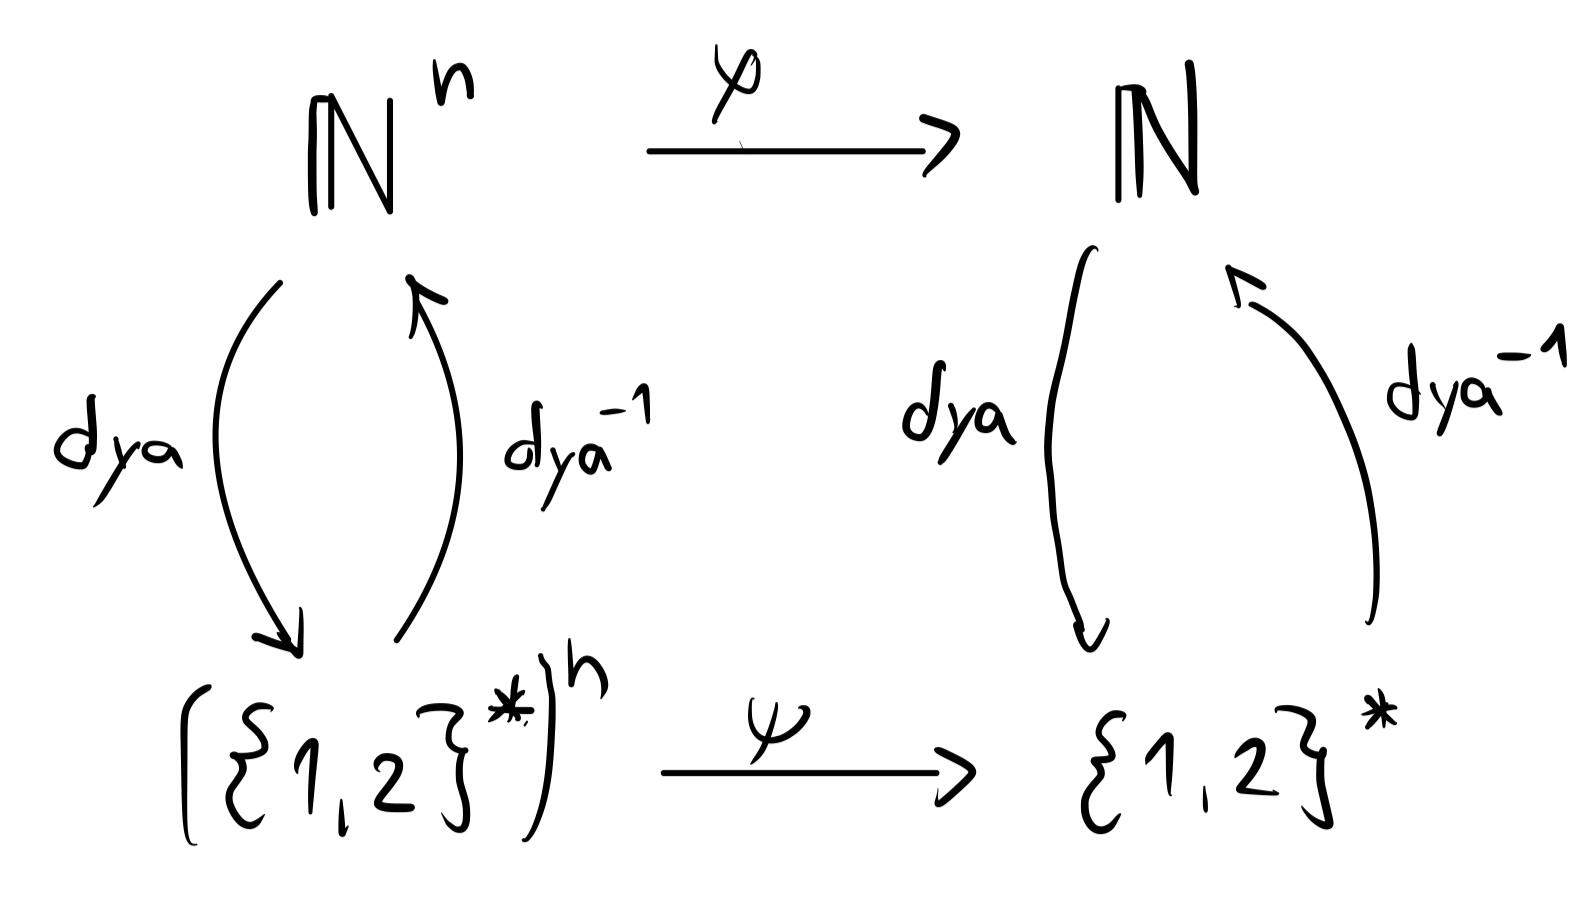
- Dazu definieren wir die Menge/Klasse \(\textbf{TM}\) der Turing-berechenbaren Funktionen als: \[ \textbf{TM} = \{ φ \mid φ : ℕ^n → ℕ \text{ ist Turing-berechenbar} \} \]
Definition: 1-Turingmaschine
Eine 1-Turingmaschine ist eine Turingmaschine mit nur einem Halb-Band. Also \(M_1 = (Σ, Z, f, z₀, z_1)\). Die Überführungsfunktion hat dann die Form:
\[ f : Z × Σ \quad → \quad Z × Σ × \{L, 0, R\} \]
Turing-Maschinen-Emulieren
Das TheoreticalComputerScience Paket enthält auch eine Implementierung von Turing Maschinen mit \(k\) Bändern:
no_bands: The number of bands.initial_state: The initial state.final_state: The final state.f:Tuple{String, Vector{Char}} => Tuple{String, Vector{Char}, Vector{Movement}}
□: Represents the blank symbol. Written with \Box
M = TMK(no_bands = 2, initial_state = "z0", final_state = "z1", f = Dict([
 #z0
 ("z0", ['a','□']) => ("z0", ['a','a'], [:R, :R]),
 ("z0", ['b','□']) => ("z0", ['b','b'], [:R, :R]),
 ("z0", ['□','□']) => ("z2", ['□','□'], [:O, :L]),
 # z2
 ("z2", ['□','b']) => ("z2", ['b','□'], [:R, :L]),
 ("z2", ['□','a']) => ("z2", ['a','□'], [:R, :L]),
 ("z2", ['□','□']) => ("z3", ['□','□'], [:L, :O]),
 # z3
 ("z3", ['a','□']) => ("z3", ['a','□'], [:L, :O]),
 ("z3", ['b','□']) => ("z3", ['b','□'], [:L, :O]),
 ("z3", ['□','□']) => ("z1", ['□','□'], [:R, :O])
 ])
)
um die Maschiene auszuführen, können Sie die execute_tm Funktion verwenden:
execute_tm(M, "abb")Die Maschiene wird dann schritt für Schritt ausgeführt, bis der Endzustand erreicht ist.
abb
↑
□□□
↑
⤷ f(z0,['a', '□'])  ⟶  (z0, ['a', 'a'], [R, R])

abb
 ↑
a□□
 ↑
⤷ f(z0,['b', '□'])  ⟶  (z0, ['b', 'b'], [R, R])
... (continues until the final state is reached)
Turingmaschienen mit nur einem Band können genauso definiert werden:
initial_state: The initial state.final_state: The final state.f:Tuple{String, Char} => Tuple{String, Char, Movement}
□: Represents the blank symbol. Written with \Box
M = TM1(initial_state = "z0", final_state = "z1", f = Dict([
  ("z0", 'a') => ("za", '□', :R),
  ("z0", '□') => ("z1", '□', :R),
  ("z0", 'b') => ("zb", 'b', :R),
  ("za", 'a') => ("za", 'a', :R),
  ("za", 'b') => ("za", 'b', :R),
  ("za", '□') => ("z´", 'a', :L),
  ("zb", 'a') => ("za", 'a', :R),
  ("zb", 'b') => ("za", 'b', :R),
  ("zb", '□') => ("z´", 'b', :L),
  ("z´", '□') => ("z1", '□', :R),
  ("z´", 'a') => ("z´", 'a', :L),
  ("z´", 'b') => ("z´", 'b', :L)
 ])
)
Sie können diese dann mit der execute_tm Funktion ausführen oder mit der execute_1tm Funktion, je nachdem ob es sich um eine 2-∞-sided Band Turingmaschine oder eine right-∞-sided Band Turingmaschine handelt:
# two-∞-sided Band
execute_tm(M, "abbabba")
# right-∞-sided Band
execute_1tm(M, "abbabba")
Aufgabe: Operationen
- Zeichnen Sie eine Turingmaschine die \(I^1_1\) berechnet.
Lösung:
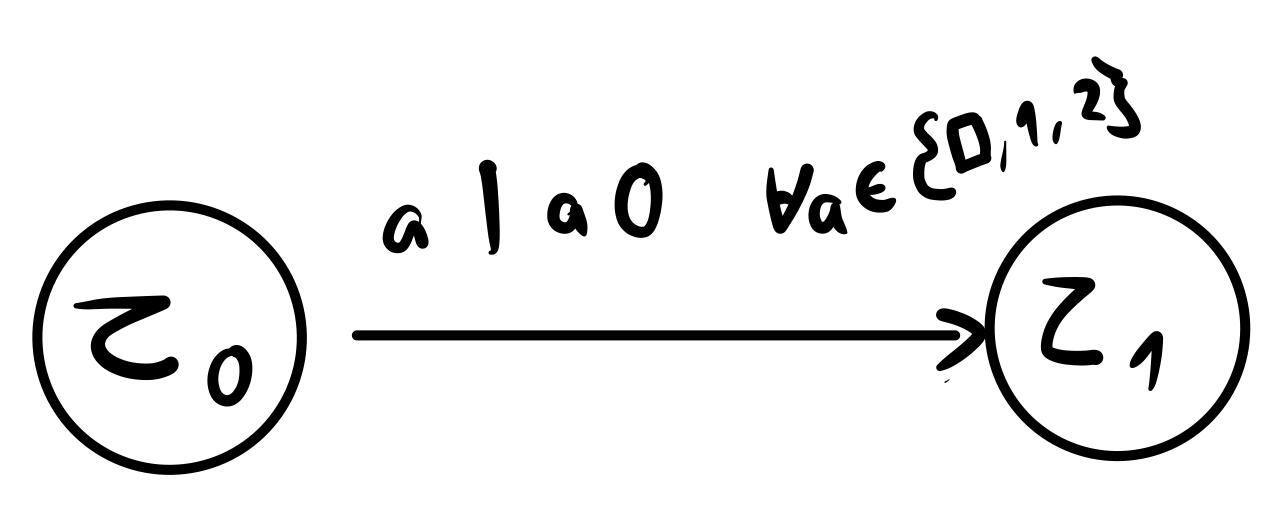
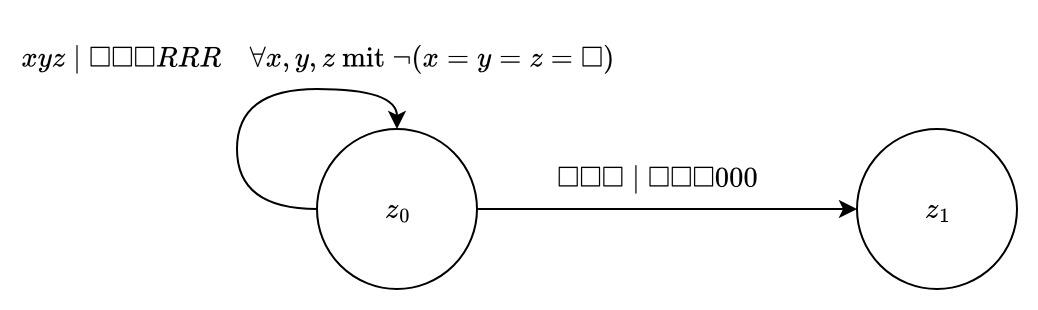
- Zeichnen Sie eine Turingmaschine die \(C^3_0(x,y,z)\) berechnet.
Lösung:
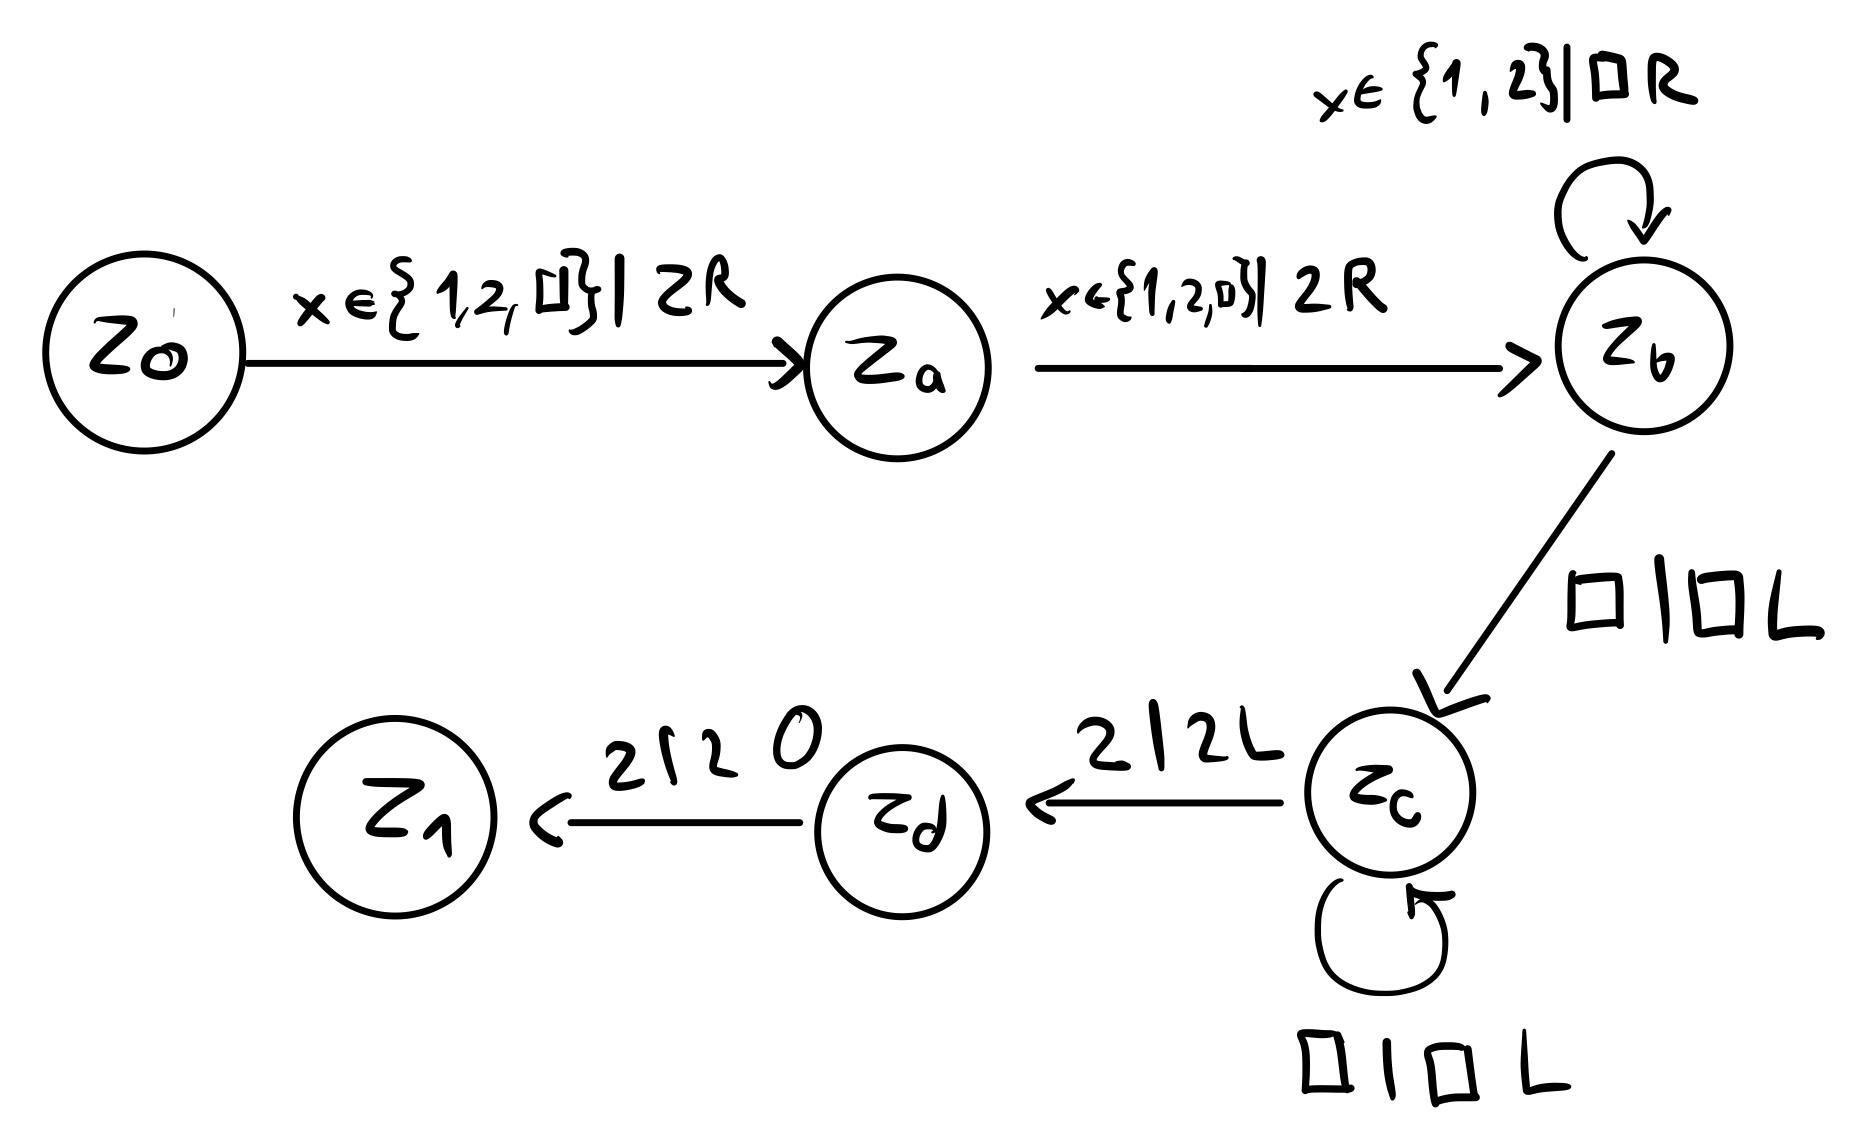
- Zeichnen Sie eine Turingmaschine die \(C^1_6(x)\) berechnet.
Lösung:
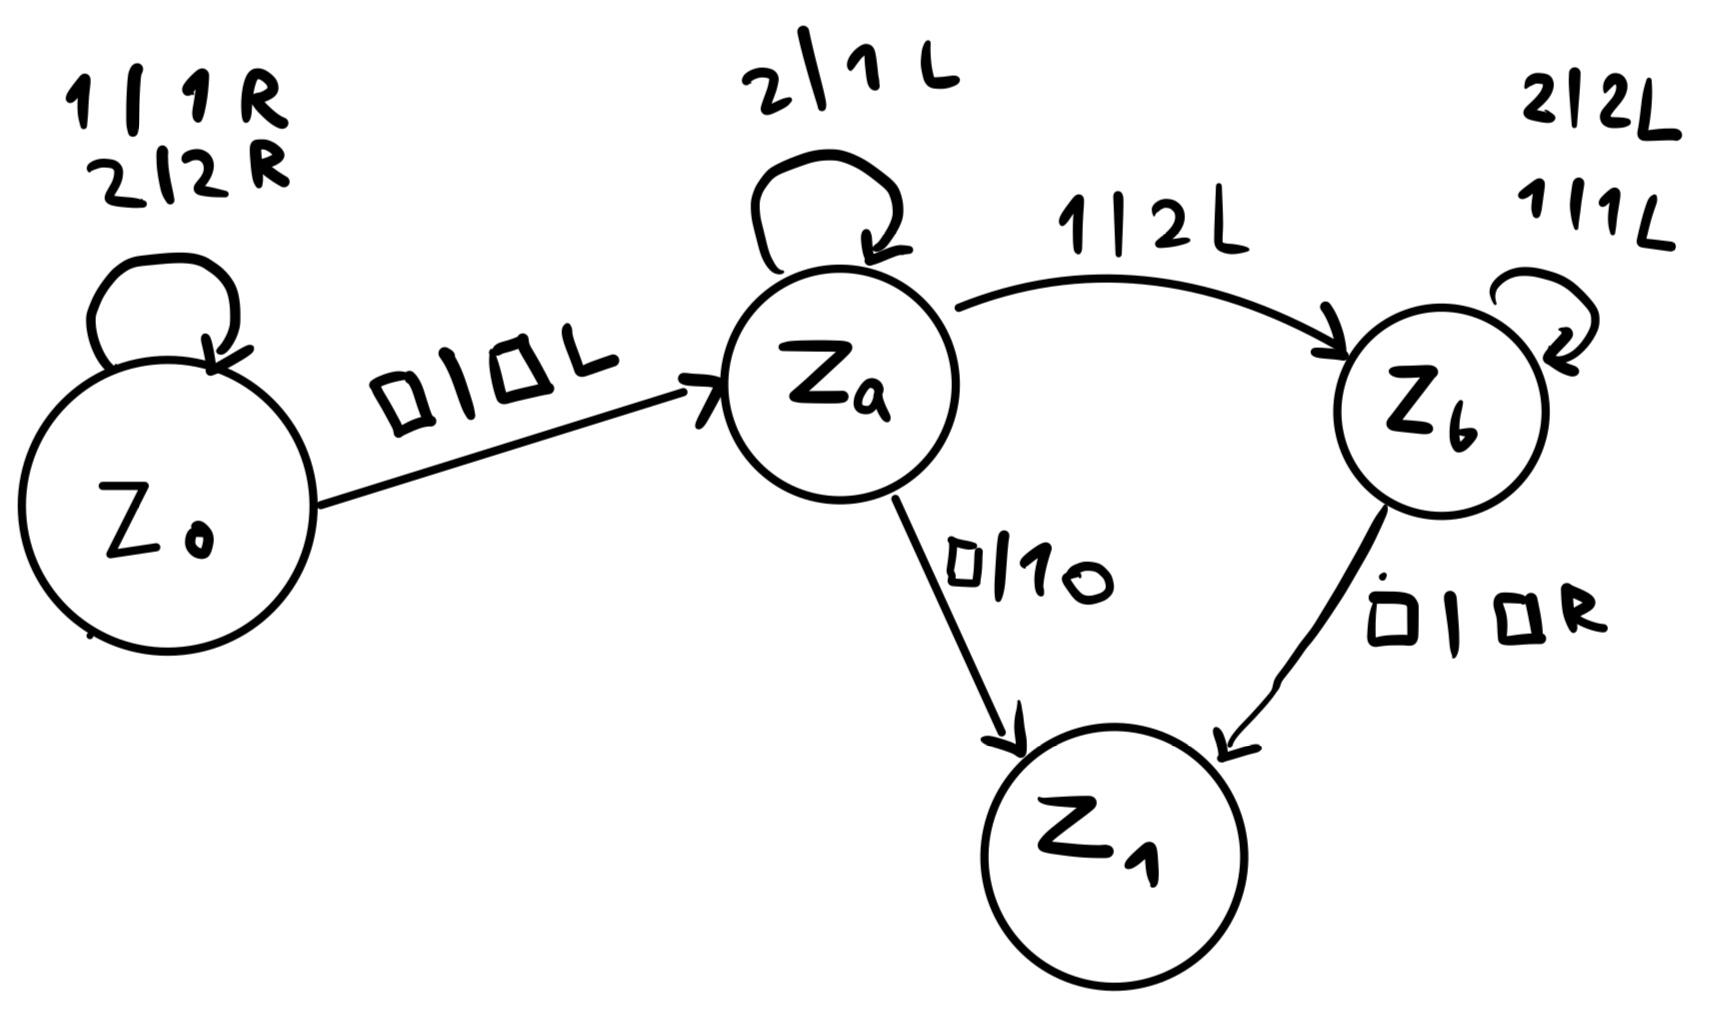
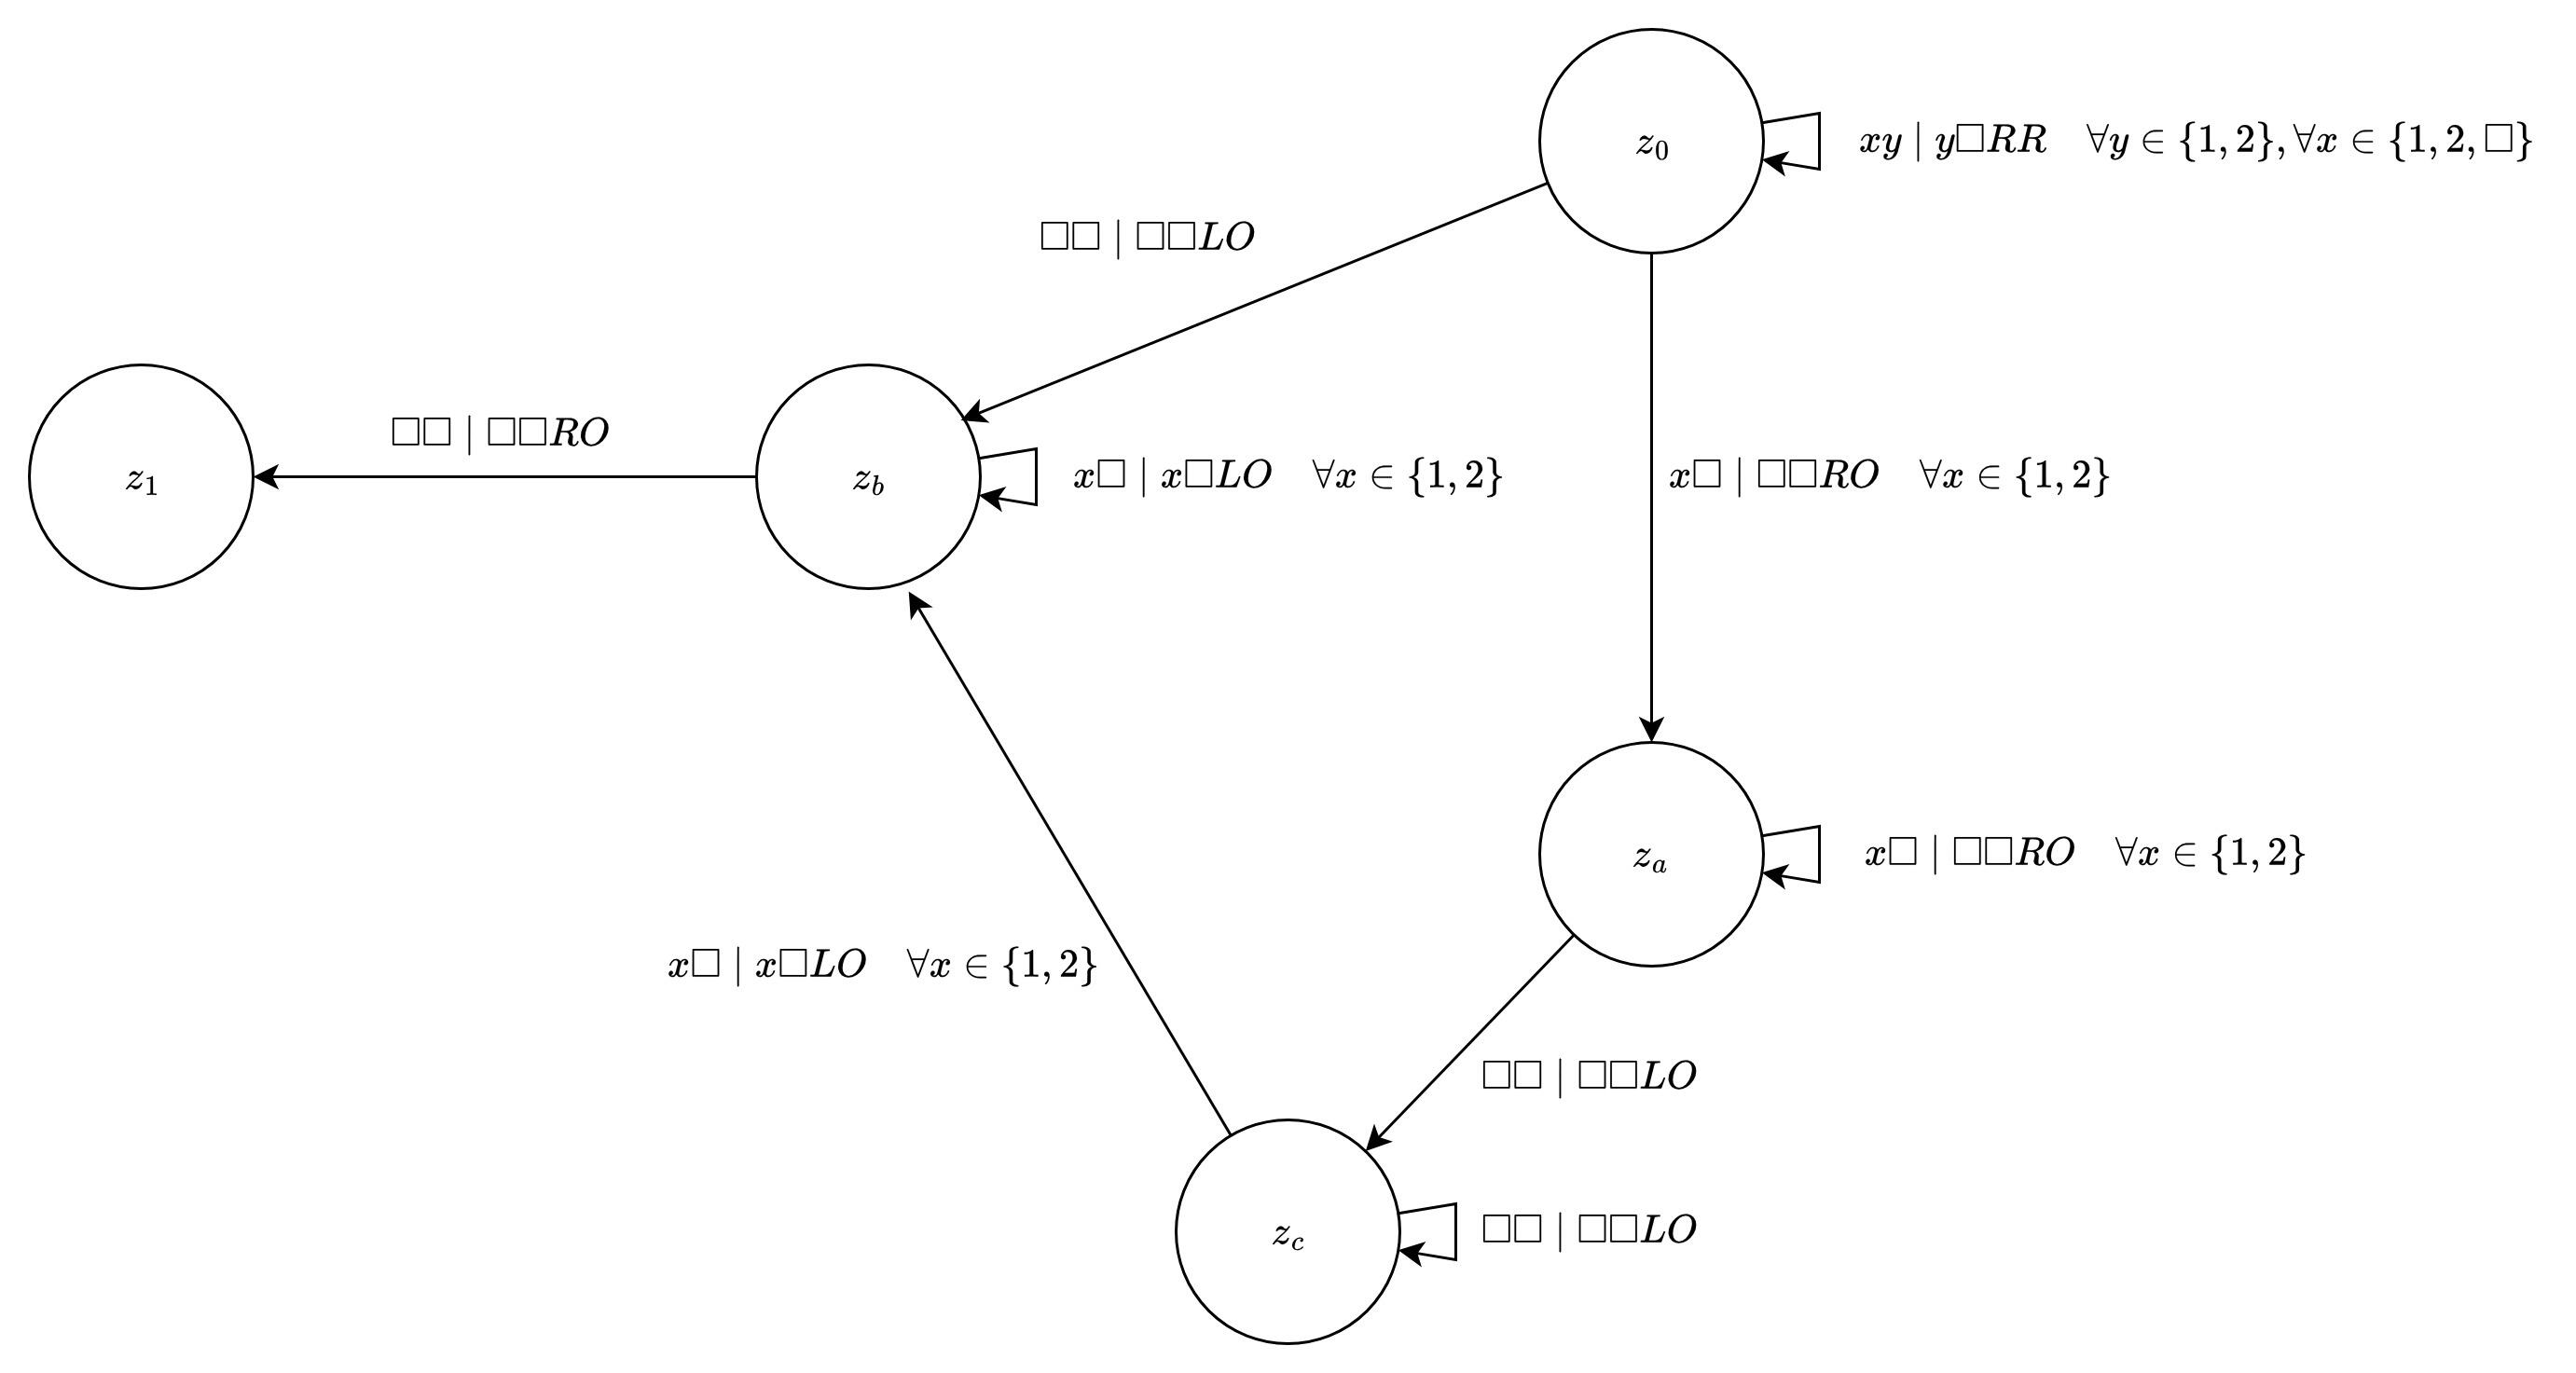
- Zeichnen Sie eine Turingmaschine die \(S(x)\) berechnet.
Lösung:
- Zeichnen Sie eine Turingmaschine die \(I^2_2\) berechnet.
Lösung:
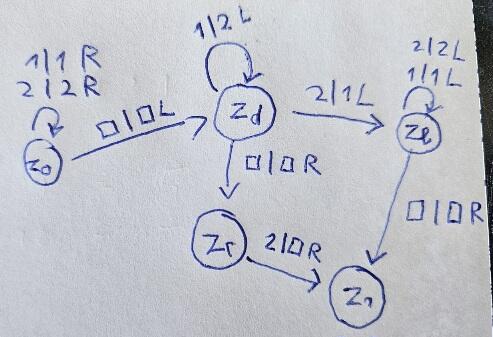
- Zeichnen Sie eine Turingmaschine die \(P(x)\) berechnet.
Lösung:
Aufgabe: \(\text{sum}(x,y)\)
- Zeit: 20 Minuten
- Überlegen Sie sich, wie viele Zustände eine Turingmaschine mindestens benötigt, um die Funktion \(\text{sum}(x,y) = x + y\) zu berechnen. Was tuen diese jeweils?
Lösung:
Wenn wir zwei dyadische Zahlen addieren wollen, müssen wir die Ziffern von rechts nach links addieren. Dabei können wir einen Übertrag von \(0-2\) haben.
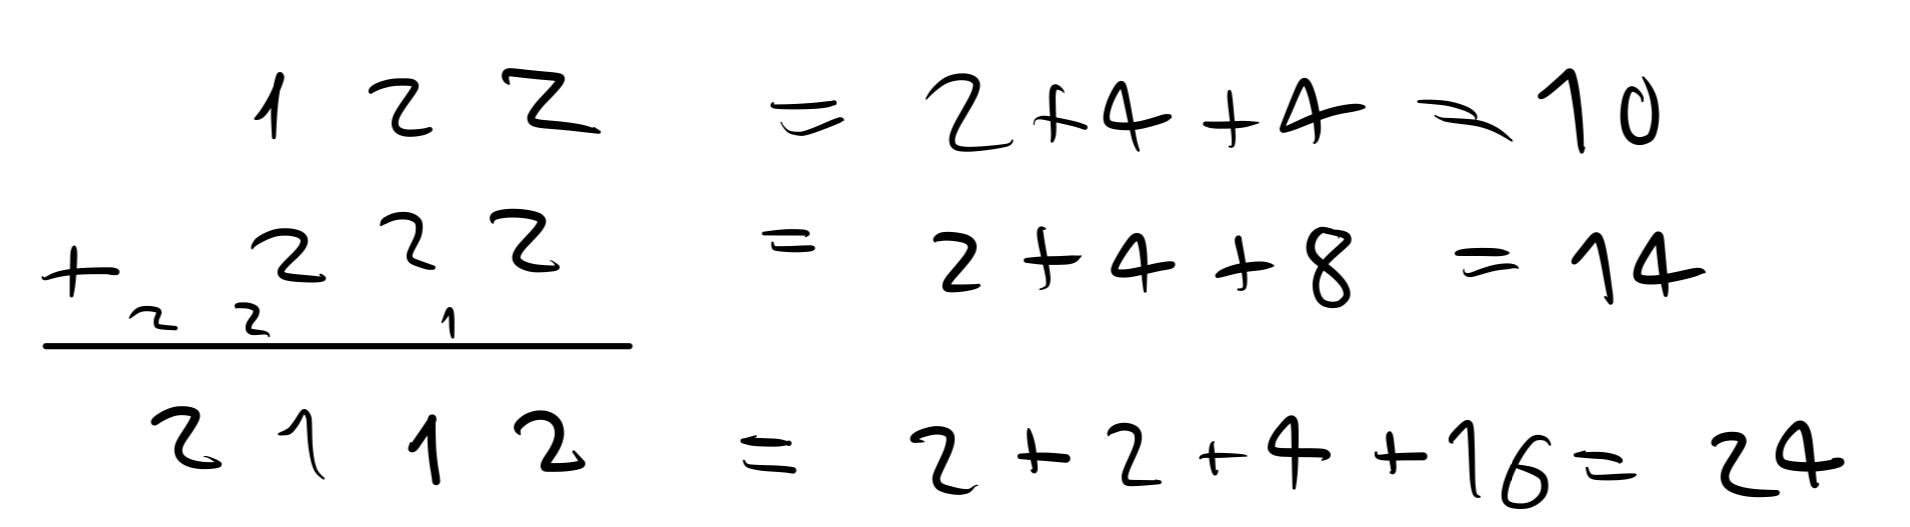
Damit erhalten wir folgende Zustände:
- \(z_0\): Startzustand, geht bis rechten Ende der Eingabe.
- \(a_0\): Addiere die Ziffern ohne Übertrag.
- \(a_1\): Addiere die Ziffern mit einem Übertrag von 1.
- \(a_2\): Addiere die Ziffern mit einem Übertrag von 2.
- \(z_1\): Endzustand, wenn die Addition fertig ist.
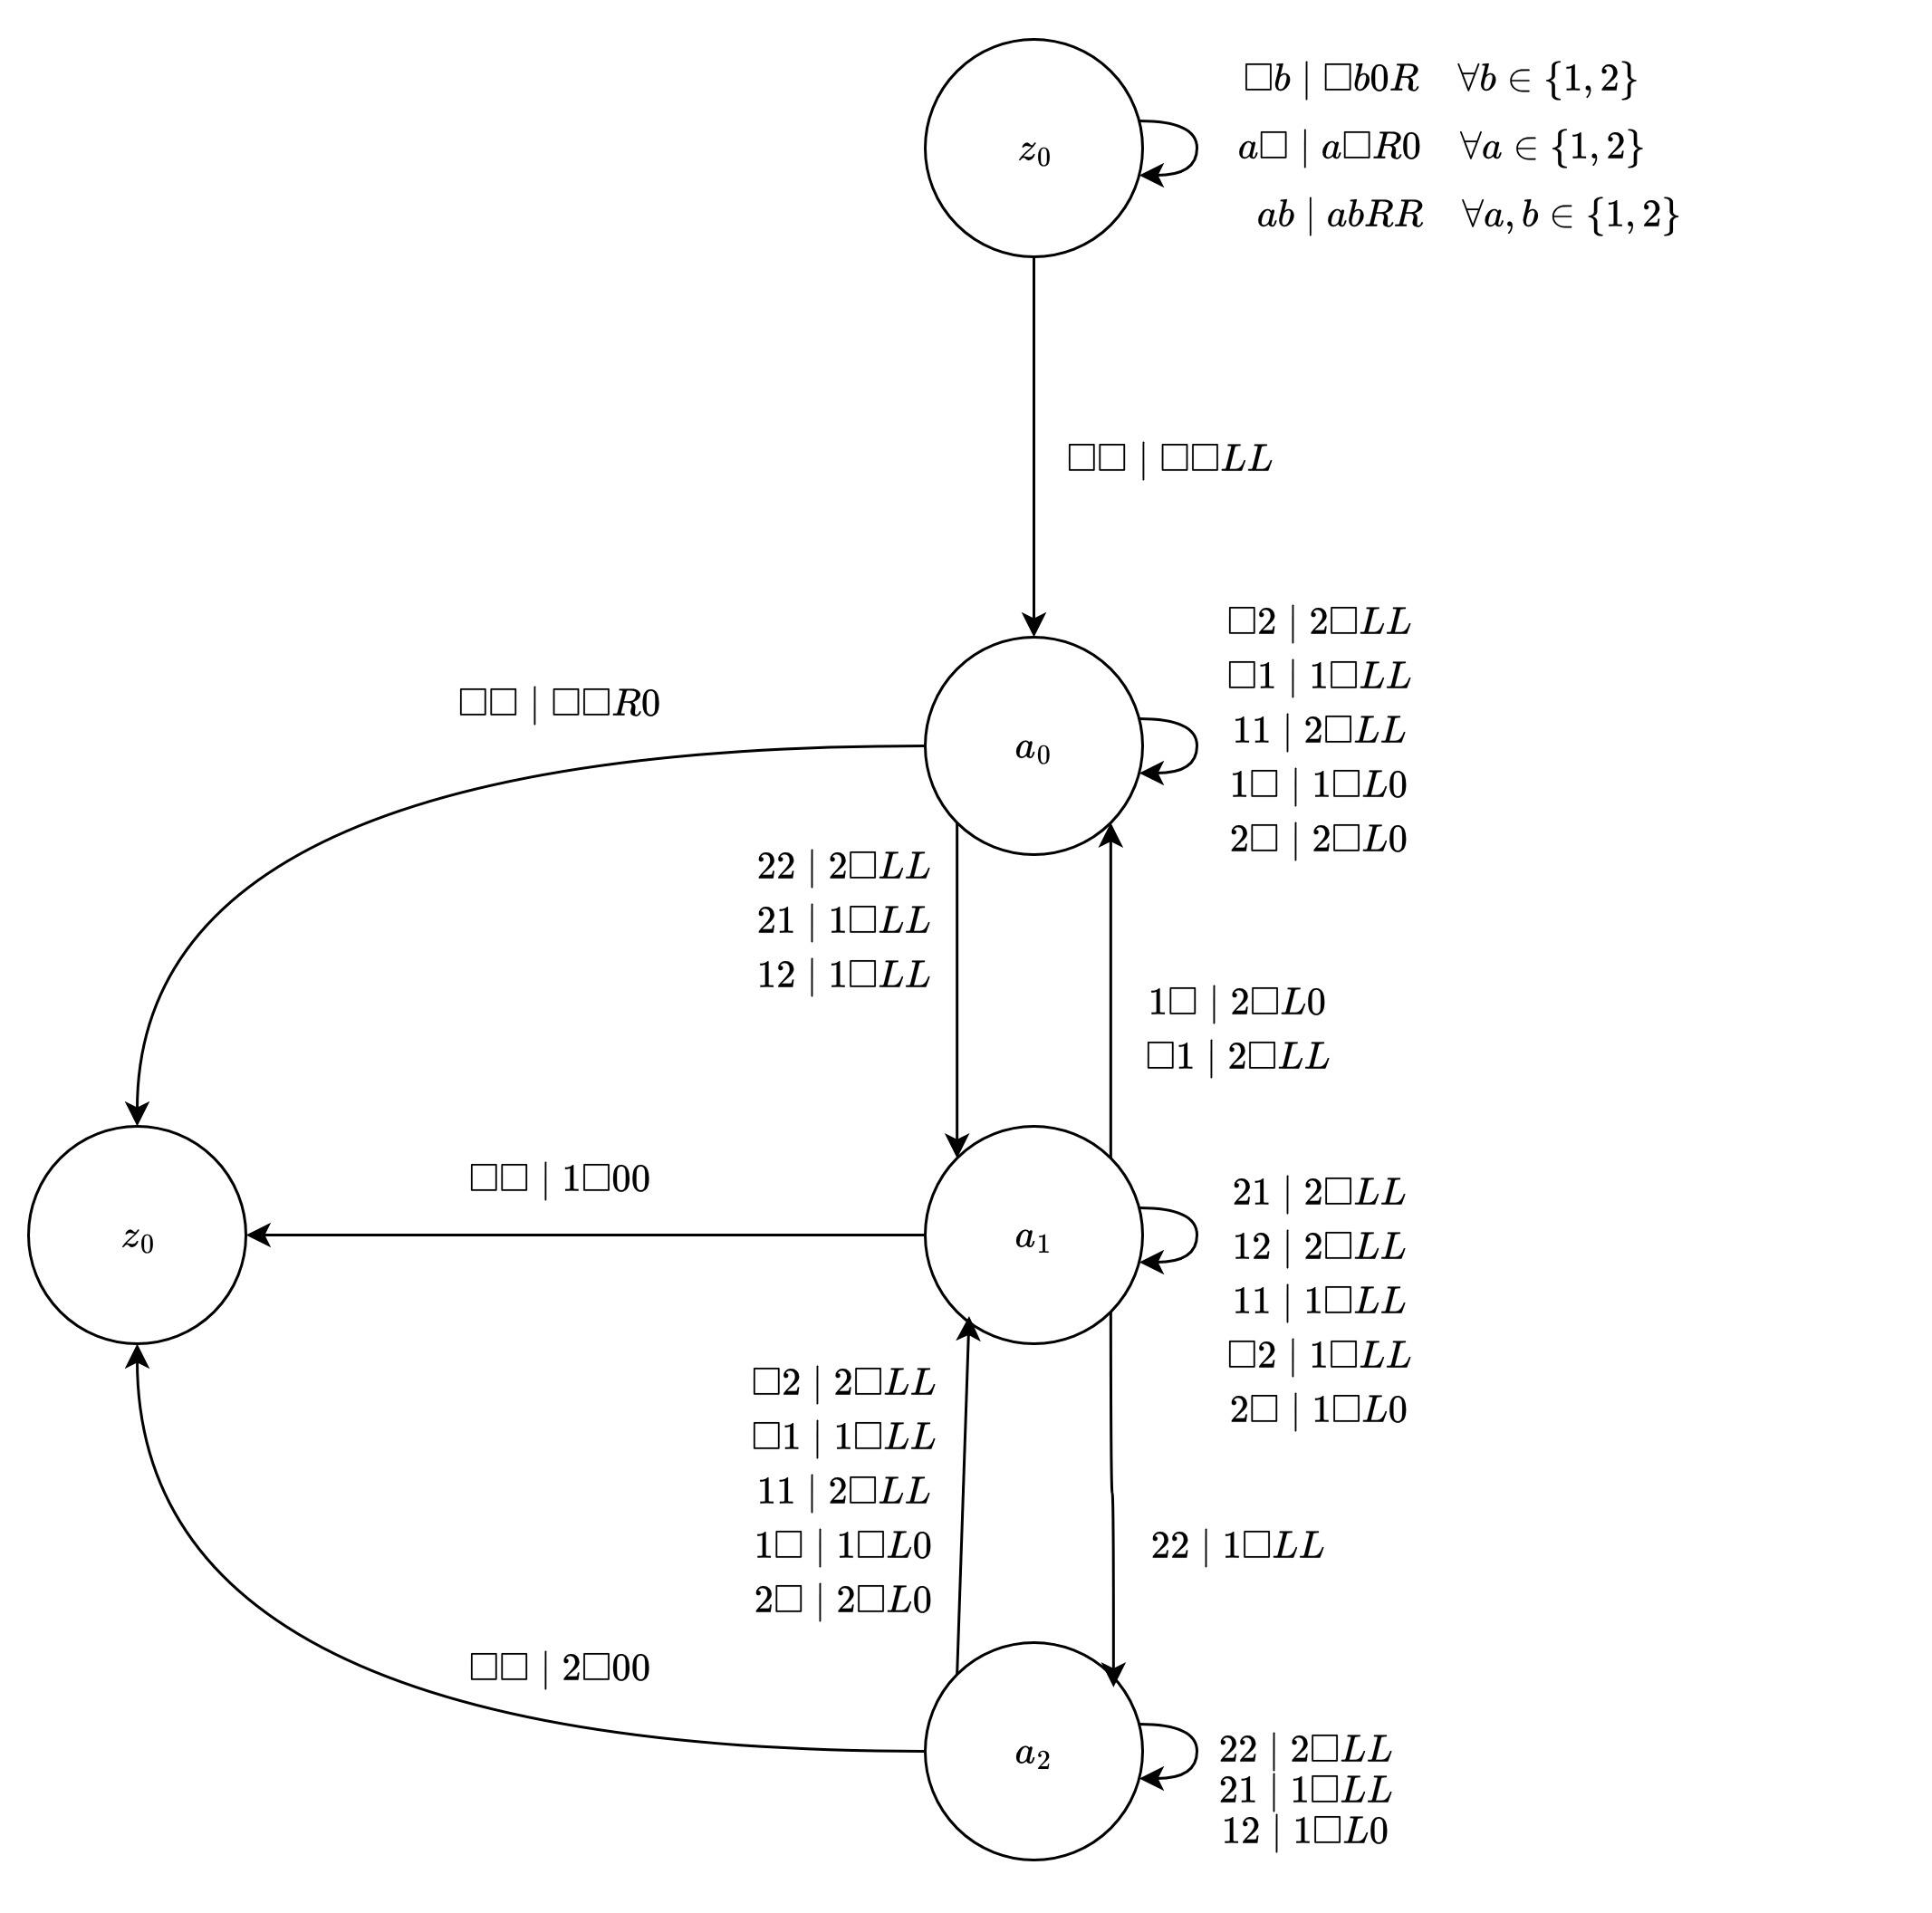
- Zeichnen Sie eine Turingmaschine, die die Funktion \[ \text{sum}(x,y) = x + y \] berechnet.
Lösung:
\(M = (\{1,2,□\},\{z_0,z_1,a_0,a_1,a_2\},z_0,z_1,f)\) mit der Überführungsfunktion \(f\) gegeben durch:
Partiell-rekursive Funktionen
Note
Das TheoreticalComputerScience Paket enthält auch eine Implementierung von partiell-rekursiven Funktionen:
https://github.com/daniel-schwarzenbach/TheoreticalComputerScience.jl#partially-recursive-functions
# max(x, y)
@show ID(ZV(ZV(SUB(psum, md))))(10,9)
@show ID(ZV(ZV(SUB(psum, md))))(9,10)

# P(x) = 1 ∸ x
@show PR(C(0,0), I(2,1))(5)

# x ↦ ⌈√x⌉
@show MIN(SIM2(md, I(2,1), SIM2(pprod, I(2,2), I(2,2))))(10)
output:
(ID(ZV(ZV(SUB(psum, md)))))(10, 9) = 10
(ID(ZV(ZV(SUB(psum, md)))))(9, 10) = 10
(PR(C(0, 0), I(2, 1)))(5) = 4
(MIN(SIM2(md, I(2, 1), SIM2(pprod, I(2, 2), I(2, 2)))))(10) = 4
Definition: Primitive Rekursion
- Es seien \(φ : ℕ^n → ℕ\) und \(ψ : ℕ^{n+2} → ℕ\) Funktionen. Dann ist die Funktion \(\text{PR}(φ, ψ) : ℕ^{n+1} → ℕ\) definiert durch:
\[ \text{PR}(φ, ψ)(x_1,...,x_n,y) = \begin{cases} φ(x_1,...,x_n) & \text{falls }y = 0 \\ ψ(x_1,...,x_n,y-1,\text{PR}(φ, ψ)(x_1,...,x_n,y-1)) & \text{sonst} \end{cases} \]
\(\textbf{PRIM} = Γ_{\text{ZV},\text{ID},\text{SUB}, \text{LV}, \text{PR}}(\{\text{S}, \text{C}^0_0, \text{I}^2_1\})\).
Eine Funktion \(f : ℕ^n → ℕ\) heißt primitiv-rekursiv, falls \(f ∈ \textbf{PRIM}\).
Die Funktion \(I^n_m\), \(C^n_m\), sum, md, prod, div, exp, prim und prex sind alle primitiv-rekursiv.
Eine Funktion ist genau dann primitiv-rekursiv, wenn sie berechnet werden kann, ohne
- While Schleifen
- Funktionsaufrufe (rekursive)
Endliche For-Schleifen und streng nicht rekursive Funktionsaufrufe (nur einmal im Callstack) sind aber erlaubt
Methode zum Erstellen/Erkennen von primitiv-rekursiven Funktionen
Wir suchen eine Funktion \(f : ℕ^n → ℕ\) die primitiv-rekursiv ist, d.h. \(f ∈ \textbf{PRIM}\). Dafür starten wir mit dem Induktionsanfang (\(y=0\)) und finden ein passendes \(φ : ℕ^n → ℕ\) so dass gilt: \[ f(x_1,...,x_n,0) = φ(x_1,...,x_n) \]
und für den Induktionsschritt (\(y>0\)) finden wir eine Funktion \(ψ : ℕ^{n+2} → ℕ\) so dass gilt: \[ \begin{aligned} f(x_1,...,x_n,y) & = ψ(x_1,...,x_n,y-1,f(x_1,...,x_n,y-1)) \\ & = \text{PR}(φ, ψ)(x_1,...,x_n,y) ∈ \textbf{PRIM} \end{aligned} \] wobei die Induktionsvoraussetzung \(f(x_1,...,x_n,y-1) = \text{PR}(φ, ψ)(x_1,...,x_n,y-1)\) ist.
Aufgabe: Widerholung
- Zeigen Sie, dass \(≤: ℕ^2 \to \{0,1\}\) in \(\textbf{PRIM}\) liegt, indem sie \(\text{md} \in \textbf{PRIM}\) verwenden.
- Zeigen Sie, dass die Funktion \(P(x) = x ∸ 1\) in \(\textbf{PRIM}\) liegt, ohne \(\text{md}\) zu verwenden.
- Hinweis: Machen Sie eine vollständige Induktion über \(x\).
- Zeigen Sie, dass die Funktion \(\text{sum}(x,y)\) in \(\textbf{PRIM}\) liegt.
- Hinweis: Machen Sie eine vollständige Induktion über \(y\).
- Zeigen Sie, dass die Funktion \(\text{prod}(x,y)\) in \(\textbf{PRIM}\) liegt, indem Sie \(\text{sum}\) verwenden.
- Hinweis: Machen Sie eine vollständige Induktion über \(y\).
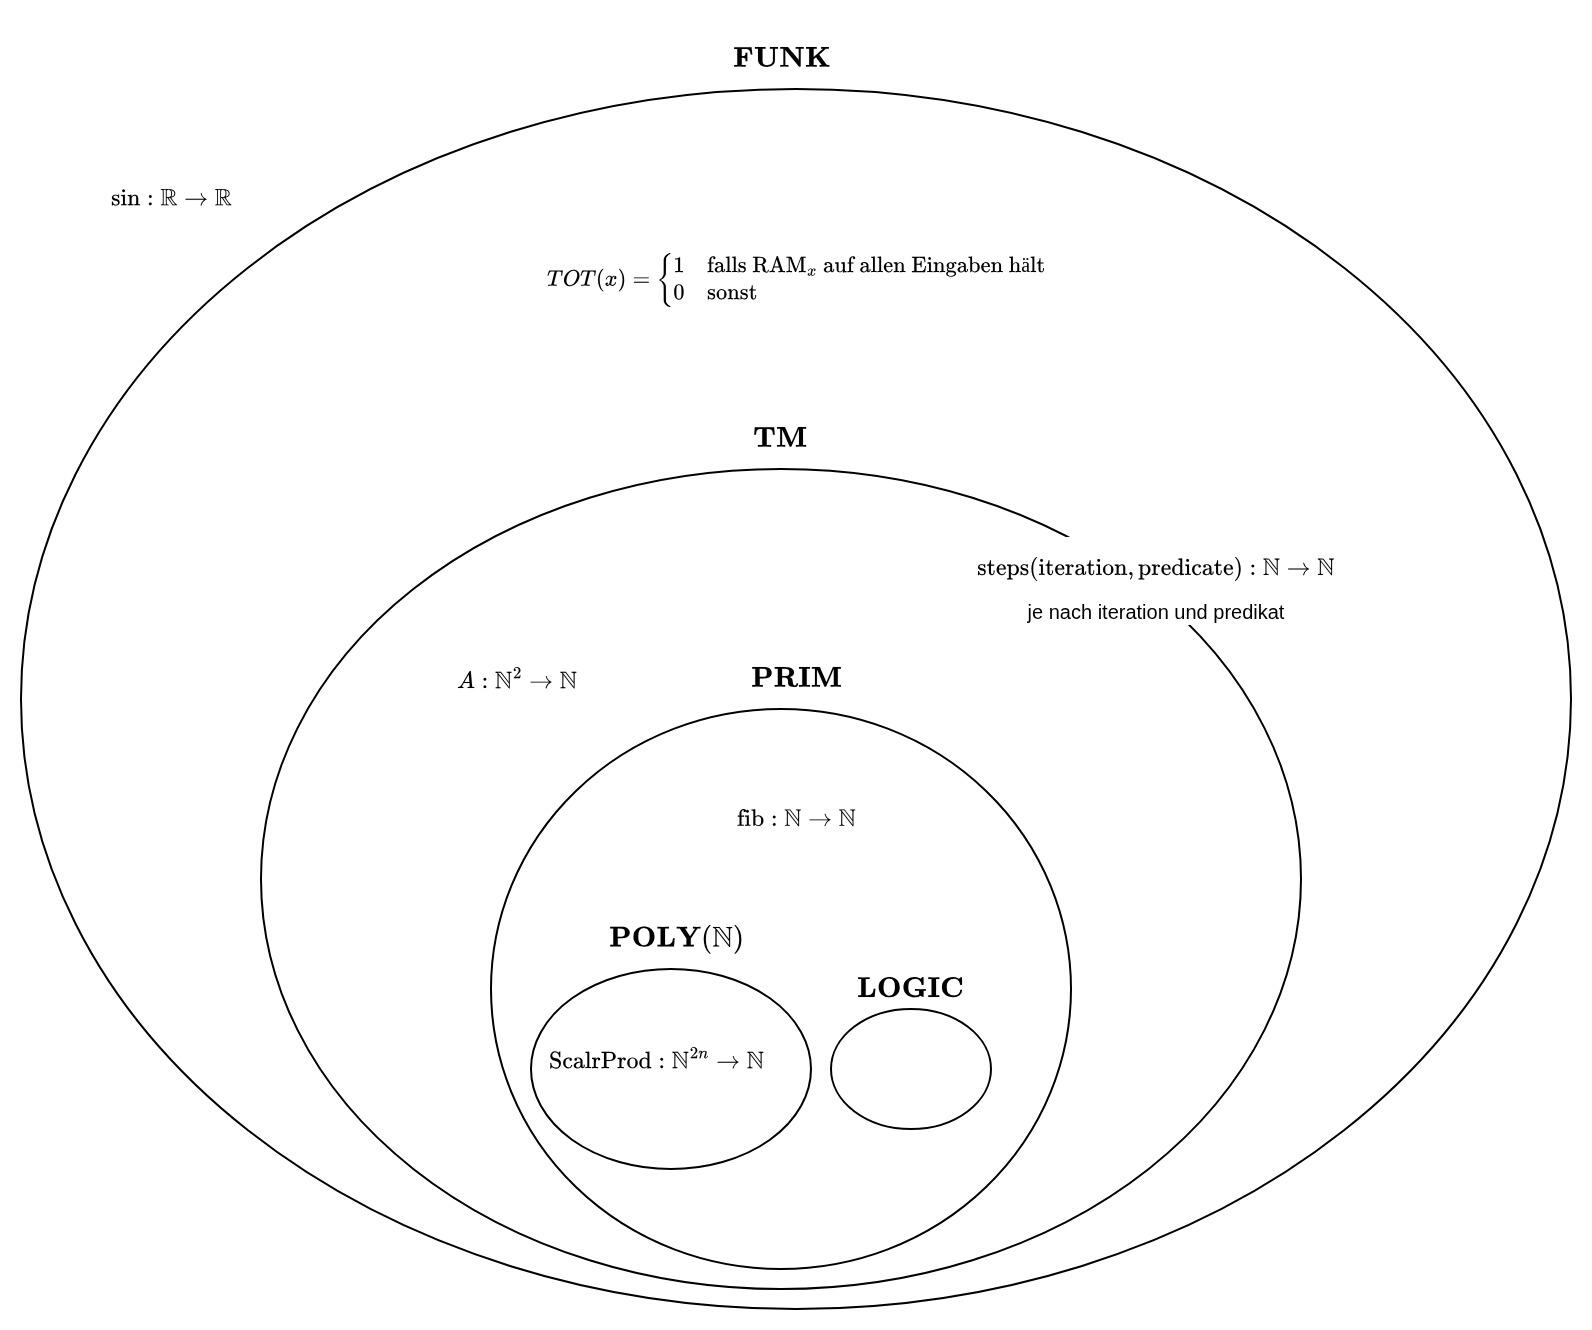
- Überlegen Sie sich welche funktionen in \(\textbf{PRIM}\) liegen und welche nicht.
Lösung:
Aufgabe: Aussagenlogische Funktionen
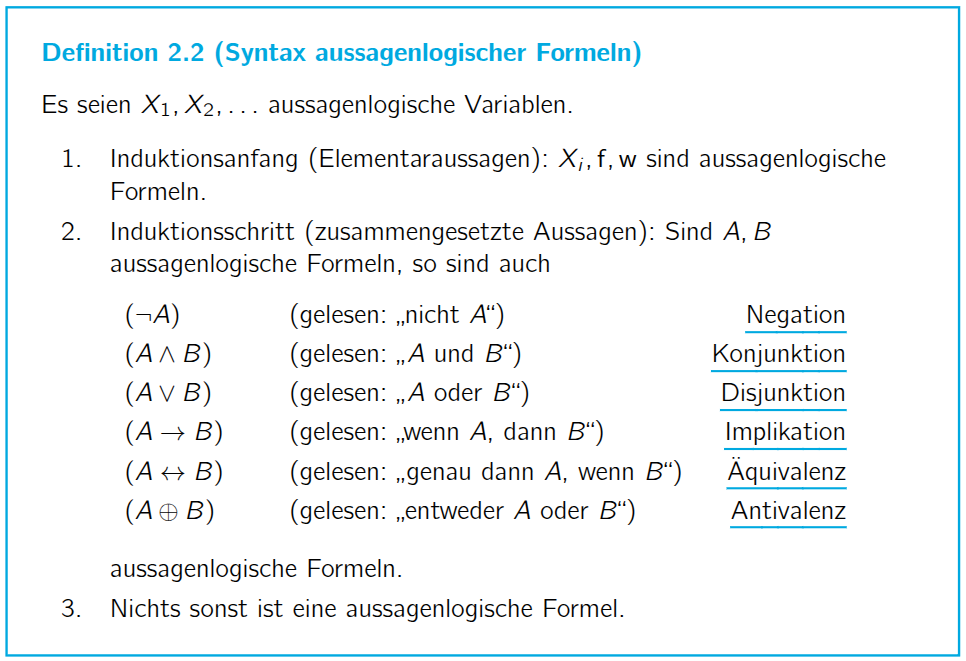
Wir wollen zeigen, dass alle aussagenlogischen Funktionen in \(\textbf{PRIM}\) liegen. Dafür verwenden wir die folgenden Funktionen: \[ \pmd, \psum, \pprod, C^n_m \; ∀ n,m ∈ ℕ, I^n_m \; ∀ n,m ∈ ℕ \text{ mit } 1 ≤ m ≤ n \]
- Zeigen Sie, dass \(f,w\) und alle \(X_1,X_2,...,X_n\) in \(\textbf{PRIM}\) liegen.
- Zeigen Sie, dass die Funktion \(¬: \{0,1\} → \{0,1\}\) in \(\textbf{PRIM}\) liegt.
- Zeigen Sie, dass die Funktion \(∧: \{0,1\}^2 → \{0,1\}\) in \(\textbf{PRIM}\) liegt.
- Argumentieren Sie, warum alle aussagenlogischen Funktionen in \(\textbf{PRIM}\) liegen.
Die Akermann-Funktion \(A : ℕ^2 → ℕ\) ist nicht primitiv-rekursiv. aber in \(\textbf{TM}\). Somit gilt: \(\textbf{PRIM} \subsetneq \textbf{TM}\). \[ A(x,y) = \begin{cases} y+1 & \text{falls } x = 0 \\ x & \text{falls } y = 0 \text{ und } x > 0 \\ A(x-1, A(x, y-1)) & \text{falls } x > 0 \text{ und } y > 0 \end{cases} \]
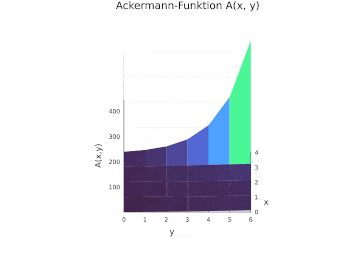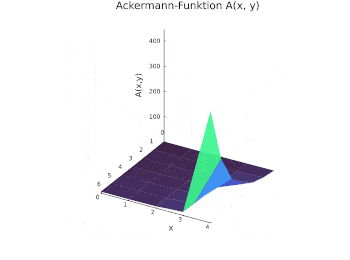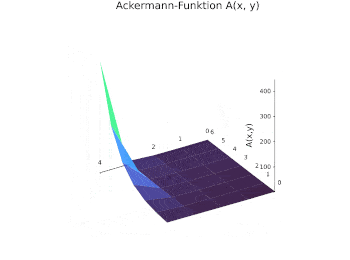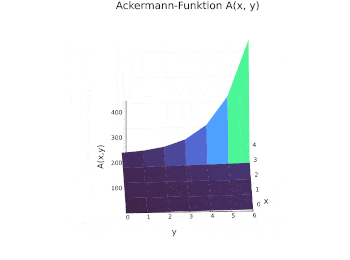
⚠️ Auf Wikipedia und in der Literatur ist sie manchmal etwas anders definiert.
Sei \(x ∈ ℕ\). Für die Akermann-Funktion \(A: ℕ^2 → ℕ\) gilt:
- \(y < A(x,y) \quad ∀ y ∈ ℕ\)
- \(A(x,y) < A(x,y+1) \quad ∀ y ∈ ℕ\)
- \(A(x,y) < A(x+1,y) \quad ∀ y ∈ ℕ\)
- \((∃z ∈ ℕ, ∀y ∈ ℕ_+)\left[A(x,y) < A(z,y-1)\right]\)
- \(A(x,2y) < A(x+3,y) \quad ∀ y ∈ ℕ\)
Sei \(f:ℕ → ℕ\) eine primitiv-rekursive Funktion mit \(n ∈ ℕ_+\). Dann gibt es ein \(x ∈ ℕ\), sodass für alle \(y_1, ..., y_n ∈ ℕ\) gilt:
\[ f(y_1,...,y_n) < A(x,y_1 + ... + y_n) \]
Aufgabe: Akermann-Funktion
- Können Sie \(A(10, 9)\) rekursiv mit ihrem eigenem Computer berechnen?
Lösung:
Im Leben nicht, da \(A(10, 9)\) eine extrem große Zahl ist. Die Anzahl der Rechenschritte würde weit über der Anzahl der Atome im Universum liegen.
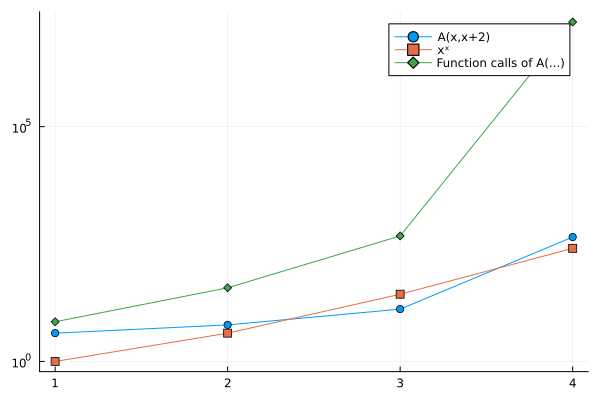
- Kann man die Akermann-Funktion ohne Rekursion berechnen?
Definition: μ-Rekursion
\(μx(E(x)) = \arg \min_{x ∈ ℕ} E(x)\), wobei \(E(x)\) eine Aussage über \(x\) ist. Also \(μx(E(x))\) ist die kleinste natürliche Zahl \(x\), für die \(E(x)\) wahr ist. Wenn es kein \(x\) gibt, für das \(E(x)\) wahr ist, dann ist \(μx(E(x))\) undefiniert.
Daher reden wir in der Theoretischen Informatik streng genommen von partiellen Funktionen von \(ℕ → ℕ\), also nur rechtseindeutige Relationen, die nicht links-total sein müssen.
Es seien \(φ : ℕ^{n} → ℕ\) eine Funktion. Dann ist die Funktion \(\text{MIN}(φ): ℕ^{n-1} → ℕ\) definiert durch: \[ \text{MIN}(φ)(x_1,...,x_{n-1}) = μy(φ(x_1,...,x_{n-1},y) = 0) \] falls es ein \(y ∈ ℕ\) gibt, für das \(φ(x_1,...,x_{n-1},y) = 0\) gilt, und undefiniert sonst.
\(\textbf{PART} = Γ_{\text{ZV},\text{ID},\text{SUB}, \text{LV}, \text{PR}, \text{MIN}}(\{\text{S}, \text{C}^0_0, \text{I}^2_1\})\).
Eine Funktion \(f : ℕ^n → ℕ\) heißt partiell-rekursiv, falls \(f ∈ \textbf{PART}\).
\[ \MIN(φ) \\ ⇔ \]
function MIN(φ::Function)
  return function (args...)
    y = 0
    while φ(args..., y) != 0
      y = y + 1
    end
    return y
  end
endHauptsatz der Algorithmentheorie
\[ ⟹ \quad \textbf{TM} = \textbf{1-TM} = \textbf{RAM} = \textbf{Julia} = \textbf{PART} \]
Church These
Jede algorithmisch berechenbare Funktion ist Turing-berechenbar.
Definition: Turing-vollständig
Ein System ist Turing-vollständig, wenn es jede berechenbare Funktion berechnen kann – also alles, was eine universelle Turingmaschine berechnen kann.
Formal: Ein Berechnungsmodell \(M\) ist Turing-vollständig, wenn gilt:
\[\forall f \text{ (Turing-berechenbar)} \Rightarrow f \text{ ist in } M \text{ berechenbar}\]
- HTML(mit CSS) ist Turing-vollständig.
- Powerpoint ist Turing-vollständig.
- Minecraft ist Turing-vollständig.
- The Game of Life ist Turing-vollständig.
- Modernes SQL mit der Möglichkeit von rekursiven Abfragen ist Turing-vollständig.
- C++ templates sind Turing-vollständig.
Berechenbarkeitstheorie
Entscheidbare Mengen
Definition: Entscheidbare Menge
Eine Menge \(A ⊆ ℕ^m\) heißt entscheidbar, falls die Charakteristische Funktion \(c_A\) berechenbar ist.
\[ c_A(x_1, ..., x_m) = \begin{cases} 1 & \text{falls } (x_1, ..., x_m) ∈ A \\ 0 & \text{falls } (x_1, ..., x_m) ∉ A \end{cases} \]
Bemerkung: Die Charakteristische Funktion \(c_A: ℕ^m → \{0,1\}\) ist eine totale Funktion, ergo muss ein Programm, das \(c_A\) berechnet, auf jeder Eingabe halten.
Seien \(A, B ⊆ ℕ^m\) mit \(m ∈ ℕ_+\).
\(A\) ist endlich \(\quad ⟹ \quad\) \(A\) ist entscheidbar.
\(A\) ist entscheidbar \(\quad ⟹ \quad\) \(\bar{A}\) ist entscheidbar.
\(A\) und \(B\) sind entscheidbar \(\quad ⟹ \quad\) \(A ∪ B\) und \(A ∩ B\) sind entscheidbar.
\(A\) ist entscheidbar und \(f:ℕ^n → ℕ^m\) berechenbar \(\quad ⟹ \quad\) \(f^{-1}(A)\) ist entscheidbar.
Aufgabe: Entscheidbarkeit
Betrachten Sie das Polynom \(p:ℕ → ℕ\) gegeben durch \[ x ↦ x - 2x^2 + x^3 \]
Zeigen Sie, dass die Menge \(A = \{x ∈ ℕ \mid ∃y \; : \; p(y) = x\}\) entscheidbar ist.
Zeigen Sie, dass die Menge \[ A = \{n ∣ n ∈ ℕ \text{ und } x^n - y^n = (x-y)^n \text{ hat eine Lösung } (x,y) ∈ ℕ^2 \text{ mit } x \neq y\} \] entscheidbar ist.
Zeigen Sie, dass der Wertebereich \(R_{f_p}\) der Funktion \(f_p: ℕ → ℕ\) mit \[ f_p(x) = \max\{p(x), 0\} \] entscheidbar ist, wobei \(p\) ein beliebiges Polynom mit ganzzahligen Koeffizienten ist.
Lösung:
Mit folgendem Programm können wir \(R_{f_p}\) entscheiden:
function C_fp(y)
    x0 = gp(y)
    for i ∈ 0:x0
        if p(i) == y
            return 1
        end
    end
    return 0
end
Dafür brachen wir aber eine berechenbare obere Grenze \(g_p(y)\), die folgende Eigenschaften hat:
\[|p(y)| ≤ | p(g_p(y) + n )| \quad ∀n ∈ ℕ\]
Wir bemerken, dass das genau dann der Fall ist, wenn \(g_p^{-1}(x) ≤ |p(x)|\) ist für alle \(x ∈ ℕ\).
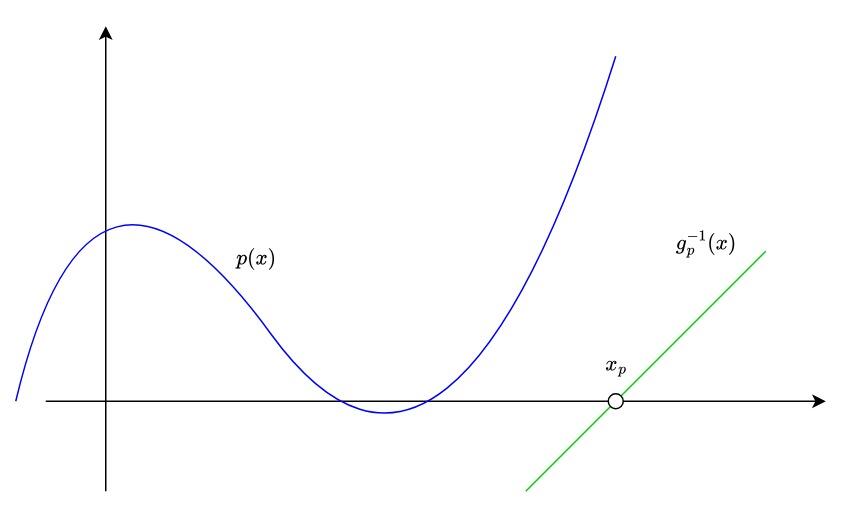
Das ganze wäre sehr einfach, wenn \(p\) monoton wächst oder fällt, da wir dann einfach \(g_p(y) = y\) setzen könnten. Der Trick ist es einen Wert \(x_p\) zu finden, nachdem es keine Nullstellen mehr geben kann und nachdem das Polynom sicher monoton wächst oder fällt. Dann hätten wir \(g_p(y) := x_p + y\).
Wir möchten also ein \(x_p\) finden, so dass gilt:
\(|p(x)| = |a_n x^n + ... + a_0 x^0| > 0\) für alle \(x > x_p\), es gibt keine Nullstellen mehr,
und
\(|δ_x\{p(x)\}| = |n a_n x^{n-1} + ... + 1 a_1 x^0| > 0\) für alle \(x > x_p\), das Polynom wächst oder fällt monoton.
\[⇐\]
\(|a_n x_p^n| ≥ |a_{n-1} x_p^{n-1} + ... + a_1 x_p^1| + |a_0 x_p^0|\)
\[⇐\]
\(|a_n x_p| ≥ |a_{n-1}| + ... + |a_0|\)
\[⇐\]
\(x_p = |a_{n-1}| + ... + |a_0|\)
Damit ist
\[g_p(y) = x_p + y\]
eine genügende hohe obere Schranke für \(y\).
gp(y) = sum(abs(a) for a ∈ coefficients[1:end-1]) + yDefinition: Aufzählbarkeit
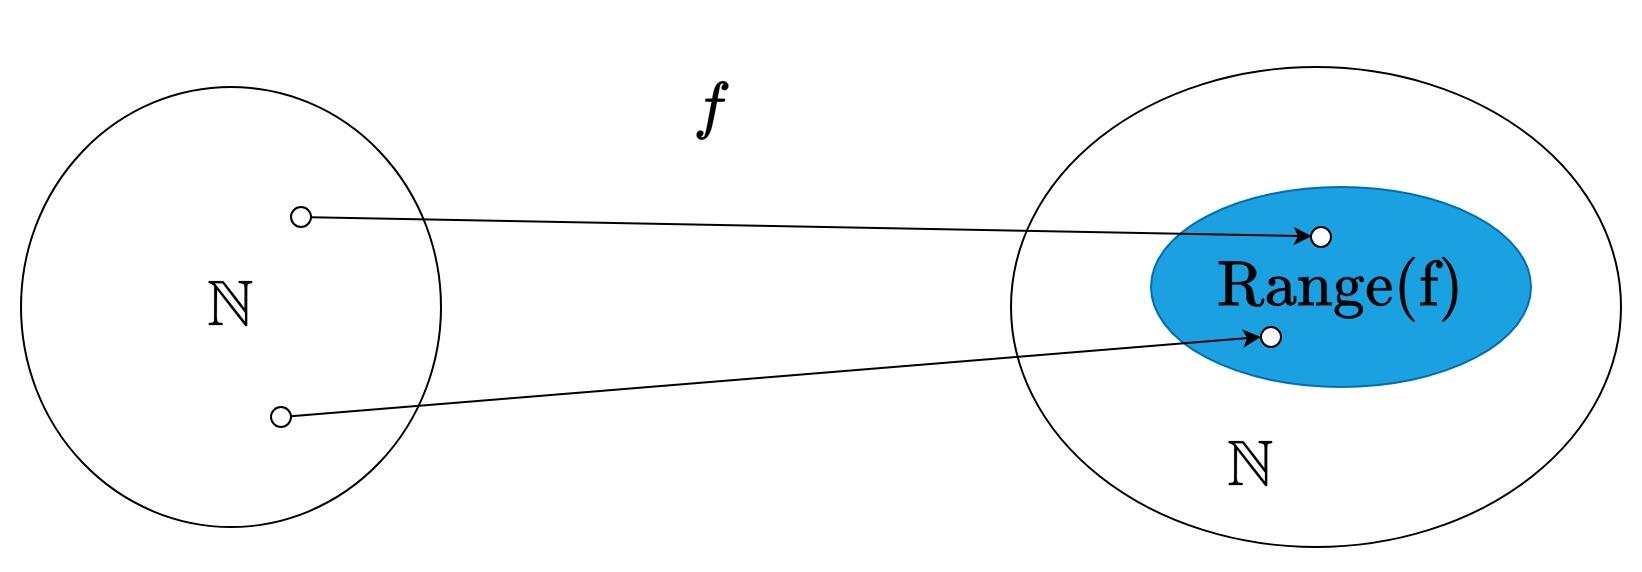
\(Y ⊆ ℕ\) heißt aufzählbar, falls \(Y = ∅\) oder es eine berechenbare Funktion \(f:ℕ → ℕ\) gibt, mit \(\text{Bild}(f) = \text{Range}(f) = R_f = Y\).
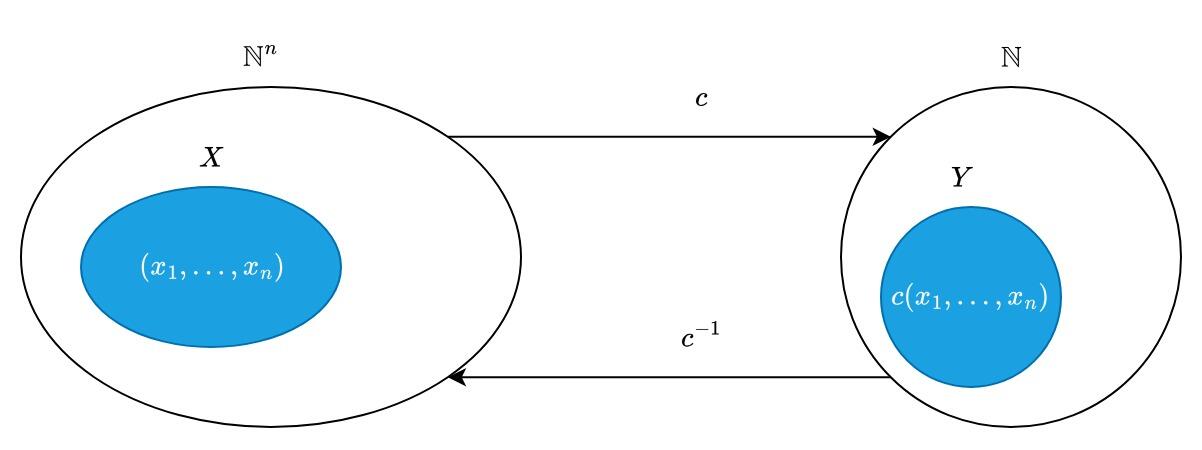
\(X ⊆ ℕ^n\) heißt aufzählbar, falls es eine bijektive, berechenbare Funktion \[c : ℕ^n → ℕ\] gibt, sodass die Menge \(Y = \{ c(x_1, ..., x_n) | (x_1, ..., x_n) ∈ X \} ⊆ ℕ\) aufzählbar ist.
Die Menge der aufzählbaren Mengen nennen wir \(\textbf{RE}\) (recursively enumerable).
Die Menge der entscheidbaren Mengen nennen wir \(\textbf{R}\) (recursive).
Die Menge der deren Komplement aufzählbar ist, nennen wir \(\textbf{co-RE}\).
Eine Menge \(A ⊆ ℕ\) ist genau dann entscheidbar, wenn \(A\) und \(\overline{A}\) aufzählbar sind.
bzw.
\[ A \text{ ist entscheidbar} \quad ⇔ \quad A \in \textbf{RE} \; ∧ \; A \in \textbf{co-RE} \]
Damit ist die Menge der entscheidbaren Mengen genau \(\textbf{R} = \textbf{RE} \cap \textbf{co-RE}\).
Sei \(f : ℕ → ℕ\) berechenbar. Dann sind \(\text{Domain}(f)=D_f\) und \(\text{Range}(f) =R_f\) aufzählbar.
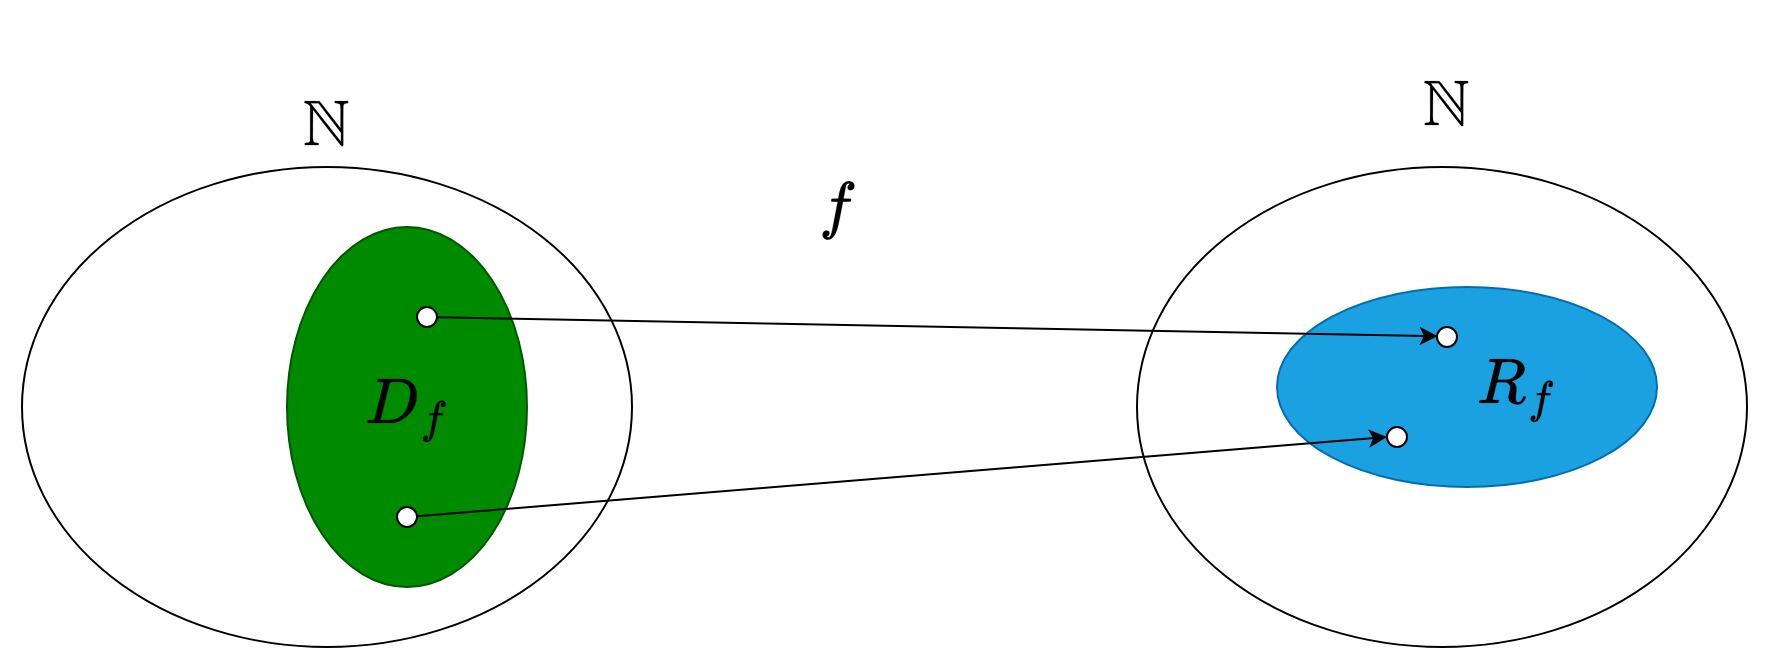
somit folgt, dass für eine beliebige Menge \(A ⊆ ℕ\) gilt:
\(A\) ist aufzählbar.
\(⇔\)
\(A\) ist Wertebereich einer einstelligen, berechnbaren Funktion.
\(⇔\)
\(A\) ist Definitionsbereich einer einstelligen, berechenbaren Funktion.
Sind \(A\) und \(B\) aufzählbar, so sind \(A ∪ B\) und \(A ∩ B\) aufzählbar.
Definition: Projektion
Für eine binäre Relation \(R ⊆ ℕ × ℕ\) definieren wir die Projektion von \(R\) als die Menge
\[ \text{Proj}(R) := \{ x ∈ ℕ \mid ∃y ∈ ℕ : (x, y) ∈ R \} \]
Projektionssatz
Es sei \(X ⊆ ℕ\). Dann ist \(X\) genau dann aufzählbar, wenn \(X\) Projektion einer binären entscheidbaren Relation \(R ⊆ ℕ × ℕ\) ist.
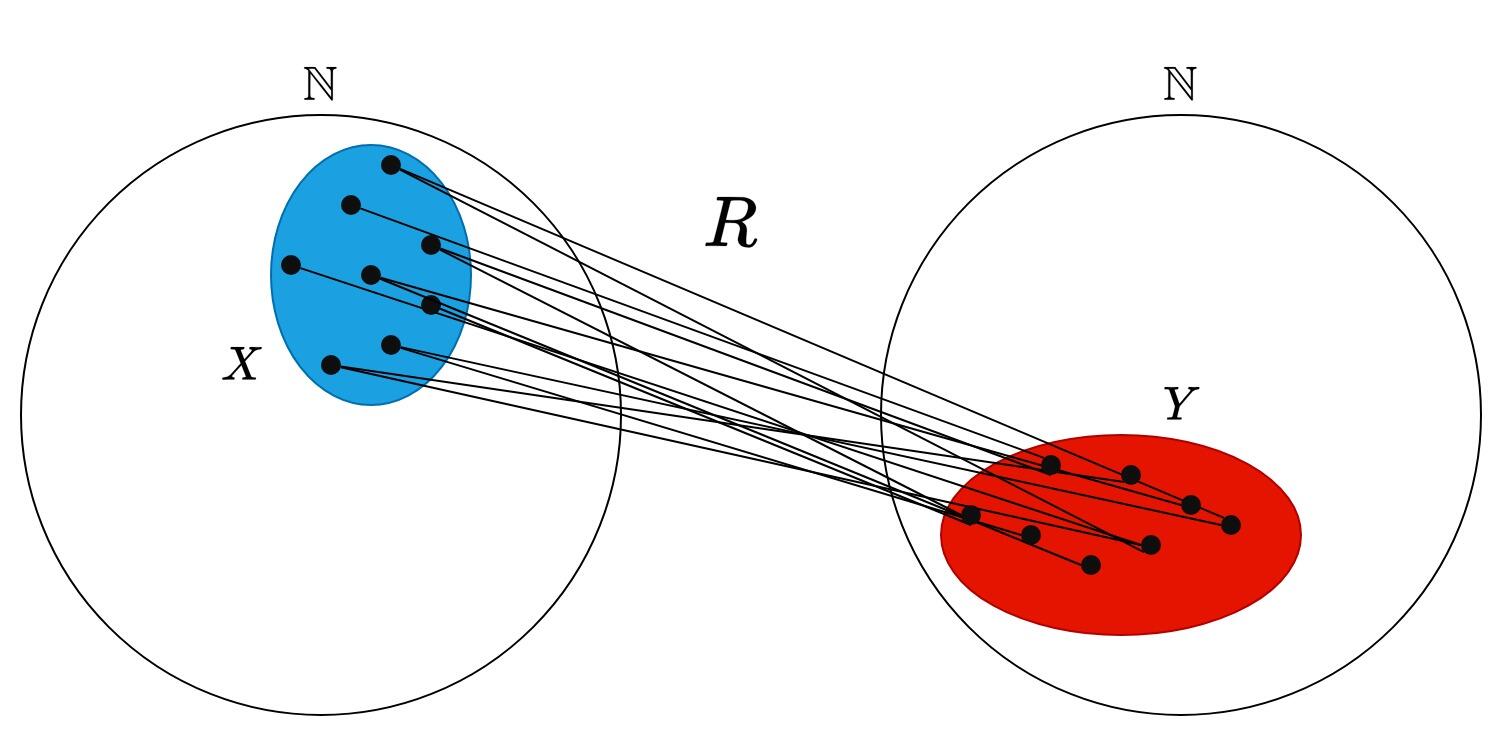
Propositionen zum Projektionssatz
- Jede Umkehrrelation einer entscheidbaren Relation ist entscheidbar.
Wir definieren die Projektion vom i-ten Argument einer n-ären Relation \(R ⊆ ℕ^n\) als die Menge \[ \text{Proj}_i(R) := \{ x_i ∈ ℕ \mid ∃x_1,...,x_{i-1},x_{i+1},...,x_n ∈ ℕ : (x_1,...,x_n) ∈ R \} \]
Mithin ist auch \(Y = \text{Proj}_2(R)\) aufzählbar, ergo gilt der Projektionssatz auch für das zweite Argument.
Sei \(R ⊆ ℕ^n\) eine entscheidbare Relation. Dann sind \(X_1 = \text{Proj}_1(R), ..., X_n = \text{Proj}_n(R)\) aufzählbar.
Unentscheidbare Mengen
Das Halteproblem
Wir können jedes RAM programm \(M_x\) als eine natürliche Zahl \(x\) kodieren.
| Symbol | R | G | I | → | + | - | = | ≠ |
|---|---|---|---|---|---|---|---|---|
| Kodierung | 111 | 112 | 121 | 122 | 211 | 212 | 221 | 222 |
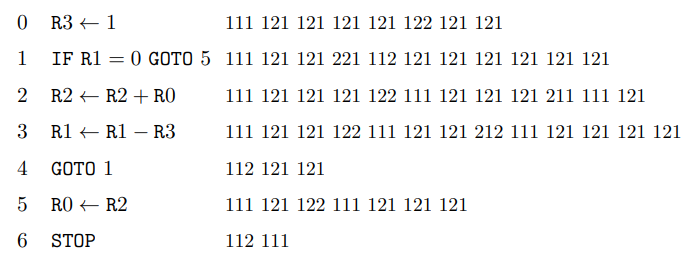
ist eine natürliche Zahl keine gültige RAM, so wird sie als STOP kodiert.
somit können wir jeder Natürlichen Zahl \(x\) eine RAM \(M_x\) zuordnen.
Diesen Vorgang nennt man auch Gödelisierung. Wir können auch funktionen von höheren Programmiersprachen wie Julia oder Python auf diese Weise kodieren. Der Vorgang ist aber auch reversibel, d.h. wir können aus einer natürlichen Zahl \(x\) die RAM \(M_x\) rekonstruieren und damit auch eine semantisch äquivalenten Julia Funktion, wie die, die wir ursprünglich kodiert haben.
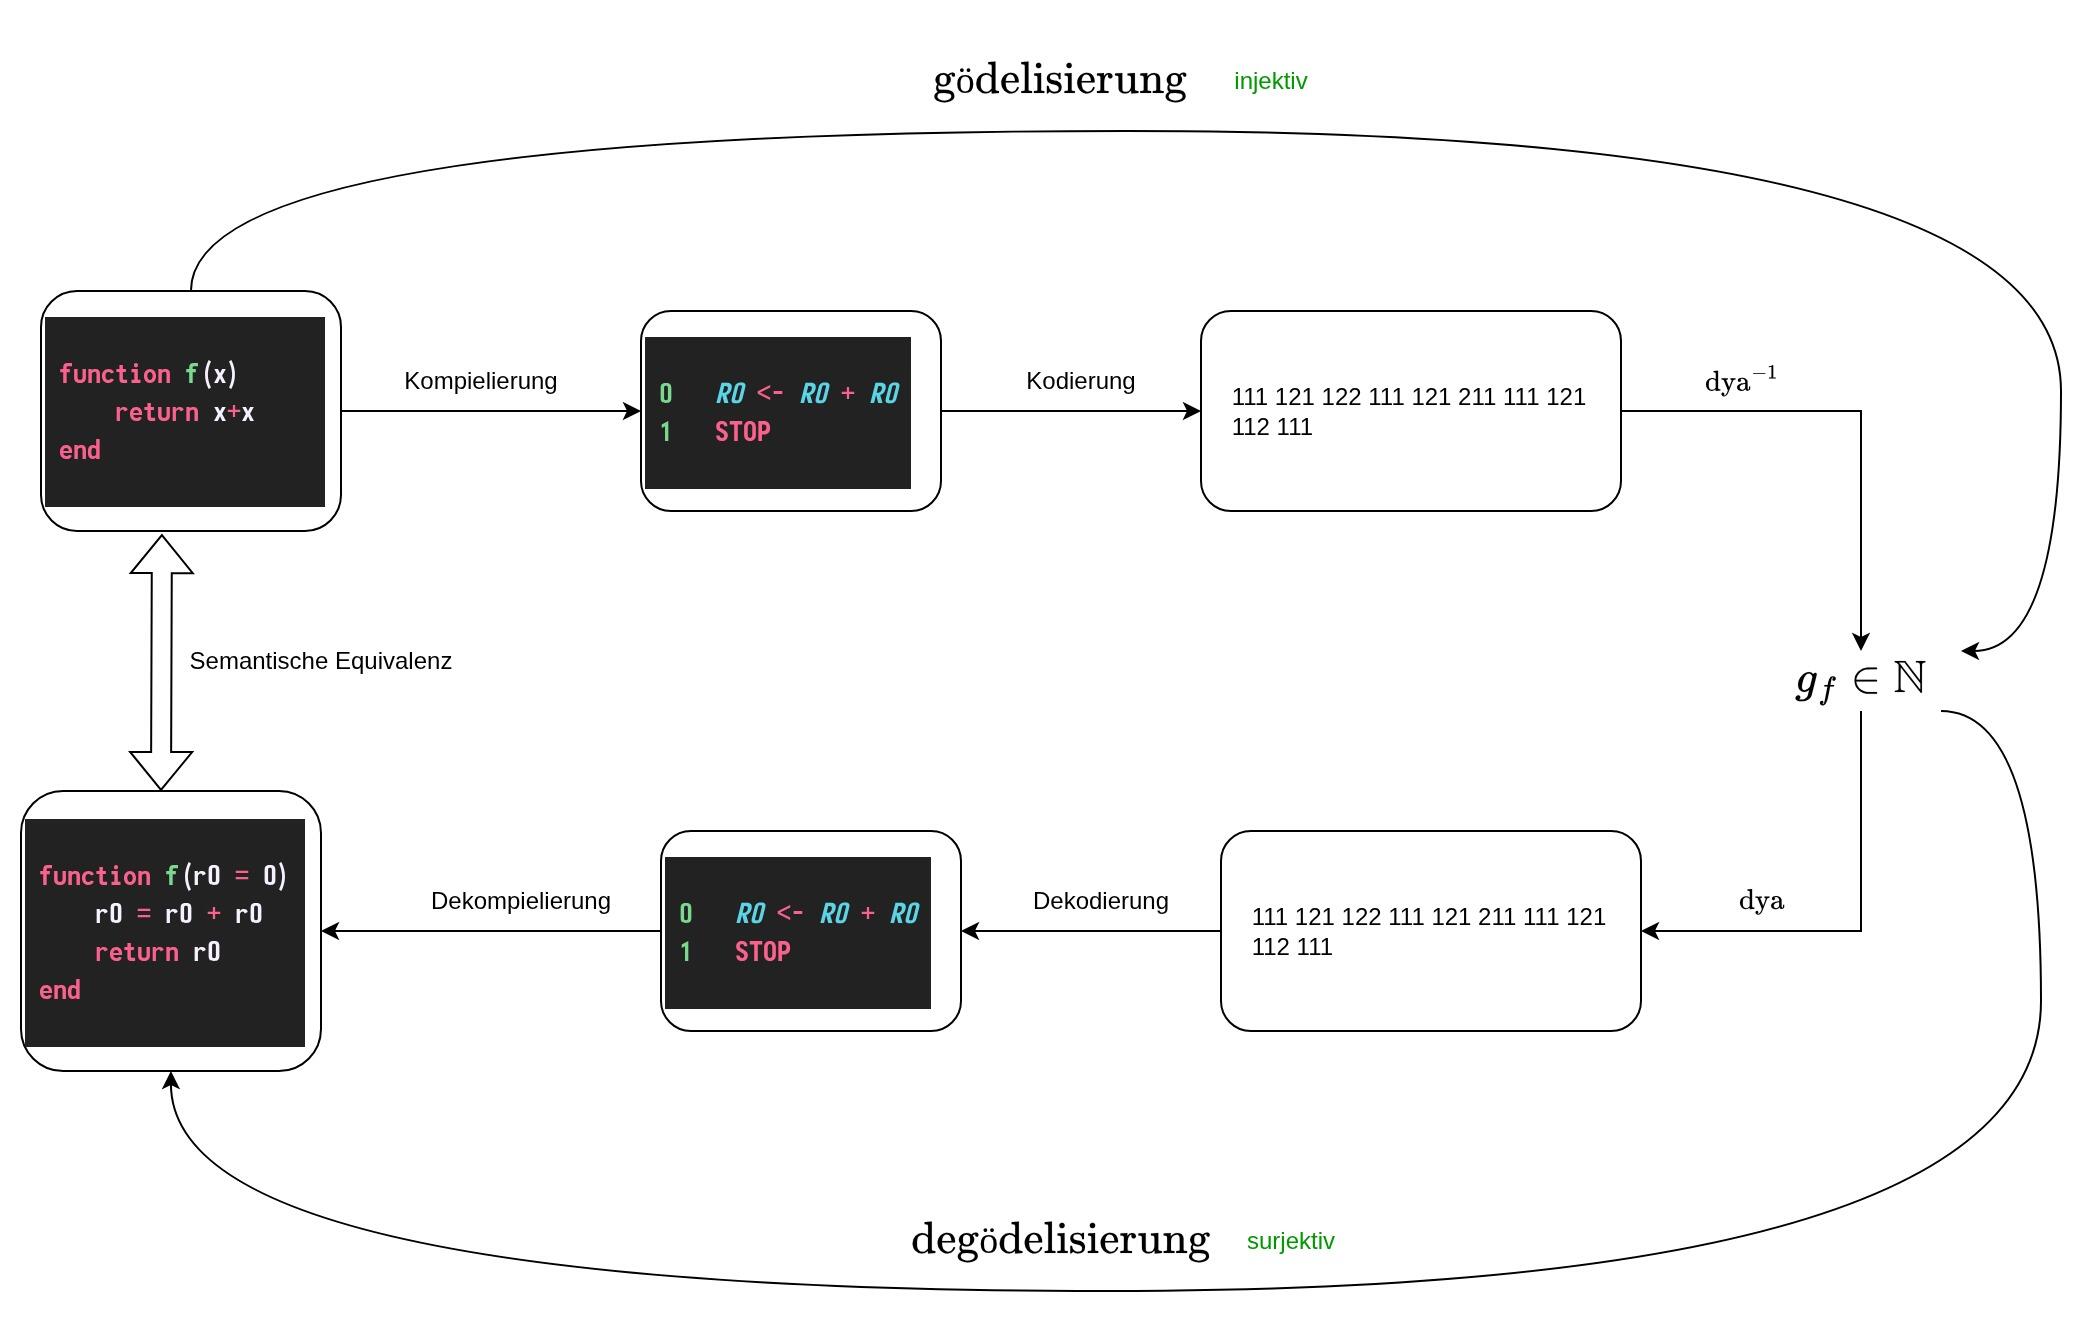
Das Halteproblem ist nicht nur für uns Informatiker ein fundamentales Problem, sondern auch für die Mathematik selbst, da es die Grenzen der Beweisbarkeit aufzeigt und zeigt das Mathematik kein abgeschlossenes System ist.
- Wichtige Stellen: 13:34 - 20:52 und 21:19 - 27:17
Das Hilbertsche Programm, initiiert von David Hilbert zu Beginn des 20. Jahrhunderts, war ein ehrgeiziger Versuch, die gesamte Mathematik auf ein sicheres, formales Fundament zu stellen. Es zielte darauf ab, die Grundlagenkrise der Mathematik zu lösen, indem die Mathematik in ein formales System überführt wird, für das drei Haupteigenschaften gefordert wurden:
Konsistenz (Widerspruchsfreiheit): In der Mathematik gibt es keine Aussage \(A\), so dass sowohl \(A\) als auch \(\neg A\) beweisbar sind.
Vollständigkeit: Für jede Aussage \(A\) in der Mathematik gilt: entweder \(A\) oder \(\neg A\) ist beweisbar.
Entscheidbarkeit: Gibt es ein Verfahren, um zu entscheiden, ob eine Aussage \(A\) aus den Axiomen eines formalen Systems beweisbar ist?
Proposition zu Hilberts Haupteigenschaften:
Es gibt kein formales System, das zeigen kann, dass die Mathematik konsistent ist, wenn sie tatsächlich konsistent ist.
Kein formales System, das die Mathematik beschreibt, ist vollständig.
Es gibt kein Verfahren, um zu entscheiden, ob eine Aussage \(A\) aus den Axiomen eines formalen Systems beweisbar ist.
Der Zusammenhang zwischen Entscheidbarkeit und Beweisbarkeit
1. Gödelisierung als Brücke
Durch Gödelisierung kann jede mathematische Aussage als natürliche Zahl kodiert werden. Damit entspricht:
\[A \subseteq \mathbb{N} \quad \Longleftrightarrow \quad \text{eine Menge von mathematischen Aussagen}\]
Die Frage „ist \(x \in A\)?” ist äquivalent zur mathematischen Frage „gilt Eigenschaft \(A\) für \(x\)?“.
2. Was bedeutet Entscheidbarkeit für Beweisbarkeit?
\[A \text{ ist entscheidbar} \quad \Longleftrightarrow \quad \forall x \in \mathbb{N}: \text{ entweder „}x \in A\text{" oder „}x \notin A\text{" ist beweisbar}\]
- Ein Algorithmus, der \(A\) entscheidet, liefert implizit für jede Instanz einen Beweis - entweder einen positiven oder einen negativen.
- Unentscheidbarkeit heißt: es gibt Aussagen, die weder beweisbar noch widerlegbar sind.
Definition: spezielles Halteproblem
Die Menge
\[ K_0 = \{x \mid \text{ die RAM } M_x \text{ hält auf die Eingabe } x \} \]
heißt spezielles Halteproblem.
\(K_0\) ist aufzählbar, aber nicht entscheidbar.
Die aufzählbare Mengen sind nicht abgeschlossen unter Komplementbildung. Insbesondere ist \(\overline{K_0}\) nicht aufzählbar.
\[ K_0 ∈ \textbf{RE} \quad ∧ \quad K_0 ∉ \textbf{co-RE} \]
Definition: allgemeines Halteproblem
Die Menge
\[ K = \{(x,y) \mid \text{ die RAM } M_x \text{ hält auf die Eingabe } y \} \]
heißt allgemeines Halteproblem.
Anmerkung: \(K\) ist ebenfalls nicht entscheidbar, aber aufzählbar.
\[ K ∈ \textbf{RE} \quad ∧ \quad K ∉ \textbf{co-RE} \]
Definition: Totalitätsproblem
Die Menge
\[ \text{TOT} = \{x \mid \text{ die RAM } M_x \text{ hält auf die Eingabe } y, \quad ∀ y \in ℕ \} \]
heißt Totalitätsproblem.
Anmerkung: \(\text{TOT}\) ist nicht aufzählbar und \(\overline{\text{TOT}}\) ist ebenfalls nicht aufzählbar.
\[ \text{TOT} ∉ \textbf{RE} \quad ∧ \quad \text{TOT} ∉ \textbf{co-RE} \]
Many to One Reduzierbarkeit
Definition: m-Reduzierbarkeit oder auch Many-to-One-Reduzierbarkeit
Seien \(A, B ⊆ ℕ\). Falls eine \(f:ℕ→ℕ\) eine totale berechenbare funktion gibt mit
\[x ∈ A \quad ⟷ \quad f(x) ∈ B\]
bzw.
\[C_A(x) = C_B(f(x))\]
sagen wir: \(A\) ist m-reduzierbar auf \(B\) bzw.
\[ A ≤_m B \]
\(f\) heißt dann Reduktionsfunktion.
Für Mengen \(A, B, C ⊆ ℕ\) gilt:
- reflexivität: \(A ≤_m A\)
- transitivität: \(A ≤_m B \; ∧ \; B ≤_m C \quad ⟹ \quad A ≤_m C\)
- \(A ≤_m B \quad ⇔ \quad \overline{A} ≤_m \overline{B}\)
- \(A ≤_m ∅ \quad ⇔ \quad A = ∅\)
- \(A ≤_m ℕ \quad ⇔ \quad A = ℕ\)
Aufgabe: many-to-one reduction
- Zeigen Sie, das \(≤_m\) reflexiv ist.
- Zeigen Sie, das \(≤_m\) transitiv ist.
- Beweisen Sie die Komplementstabilität der m-Reduktion, d.h. zeigen Sie, dass für Mengen \(A, B ⊆ ℕ\) gilt:
\[ A ≤_m B \quad ⇔ \quad \overline{A} ≤_m \overline{B} \]
- Zeigen sie dass
\[ ∅ ≤_m A, \quad ∀ A ⊊ ℕ \]
und
\[ ℕ ≤_m A, \quad ∀ A ⊆ ℕ \;∧\; A ≠ ∅ \]
- Welche Eigenschaft fehlt, damit \(≤_m\) eine Äquivalenzrelation ist? Und welche Eigenschaft fehlt, damit \(≤_m\) eine Halbordnung, oder Ordnung ist? Inwiefern erzeugt \(≤_m\) Klassen von Mengen und ordnet diese?
Lösung:
Die Symmetrie fehlt, damit \(≤_m\) eine Äquivalenzrelation ist. Die Antisymmetrie und die Linearität fehlen, damit \(≤_m\) eine Ordnungsrelation ist.
Eine solche Relation nennen wir eine Präordnung.
Ähnlich wie bei Äquivalenzrelationen erzeugt sie Klassen von Mengen, aber ordnet diese partiell!
Mithin gibt es die Äquivalenzklassen:
- \(\{ℕ\}\)
- \(\{∅\}\)
- \((\textbf{RE}\cap \textbf{co-RE}) \setminus \{ℕ, ∅\}\)
- \([K]_{≡_m}\)
- \([\overline{K}]_{≡_m}\)
- \([TOT]_{≡_m}\)
- \([\overline{TOT}]_{≡_m}\)
- und unendlich viele weitere Äquivalenzklassen von unentscheidbaren Mengen.
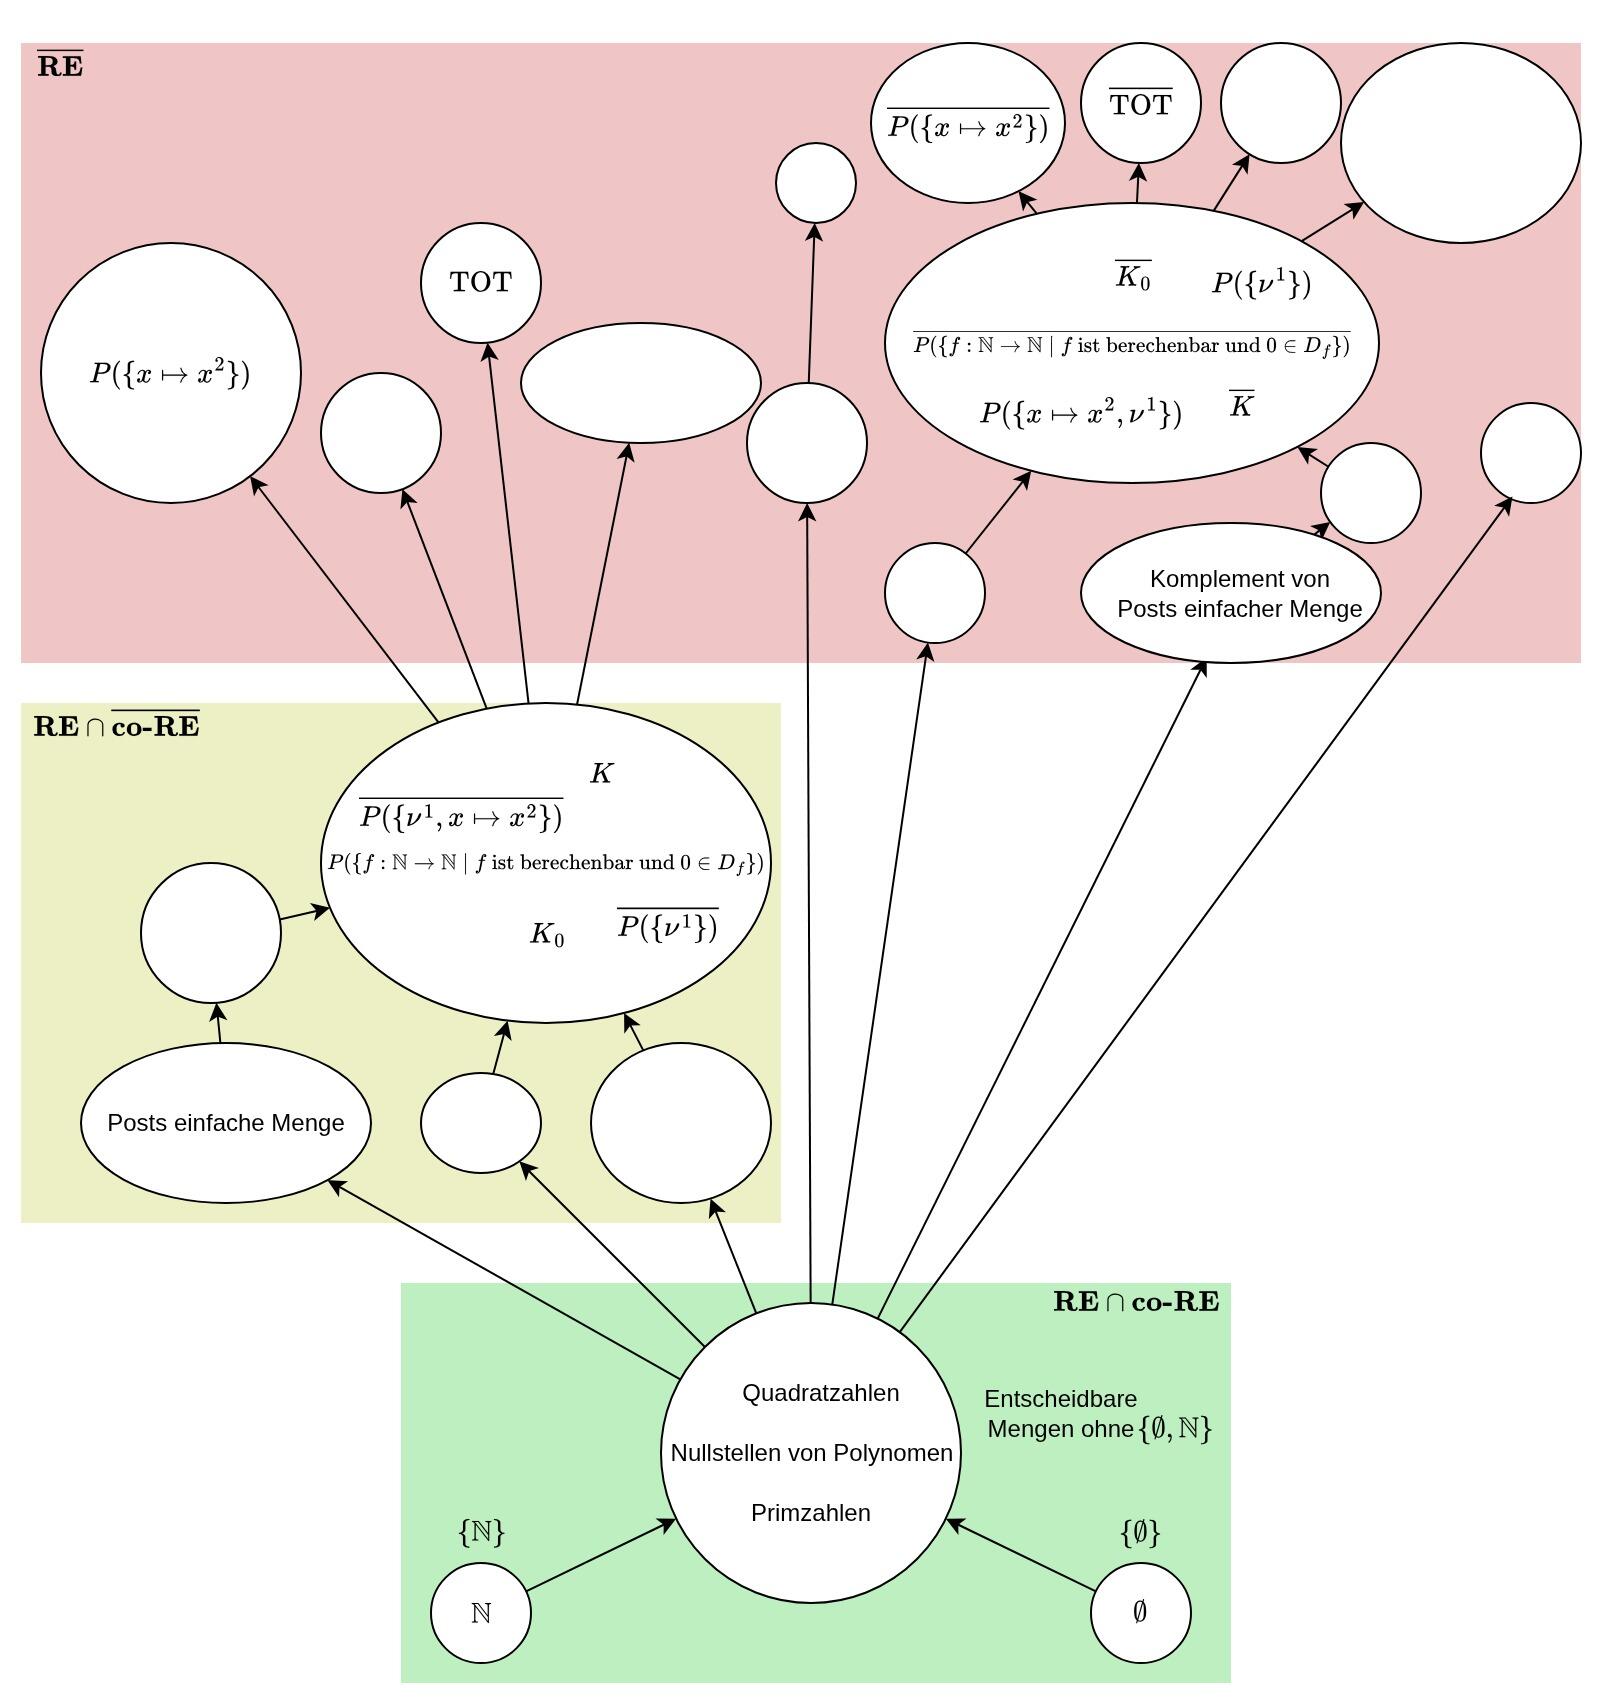
\(≡_m := \{(A, B) \mid A, B ⊆ ℕ \text{ und } A ≤_m B \text{ und } B ≤_m A\}\) ist eine Äquivalenzrelation auf \(P(ℕ)\).
Mithin gibt es die Äquivalenzklassen:
- \(\{ℕ\}\)
- \(\{∅\}\)
- \((\textbf{RE}\cap \textbf{co-RE}) \setminus \{ℕ, ∅\}\)
- \([K]_{≡_m}\)
- \([\overline{K}]_{≡_m}\)
- \([TOT]_{≡_m}\)
- \([\overline{TOT}]_{≡_m}\)
- und unendlich viele weitere Äquivalenzklassen von unentscheidbaren Mengen.
Für Mengen \(A, B ⊆ ℕ\) gilt:
- Ist \(A\) entscheidbar und ist \(B ∉ \{∅, ℕ\}\), so gilt \(A ≤_m B\)
- Gilt \(A ≤_m B\) und ist \(B\) entscheidbar, so ist \(A\) entscheidbar.
- Gilt \(A ≤_m B\) und ist \(B\) aufzählbar, so ist \(A\) aufzählbar.
Theorem von Myhill (1955)
Für jede aufzählbare Menge \(A\) gilt \(A ≤_m K_0 ≡_m K\).
Beweis:
Wir benötigen dafür die Gödelisierung. Die Gödelisierung ist eine injektive Funktion, die eine surjektive Umkehrfunktion hat. Diese können wie folgt in Julia deklariert werden:
# injektiv
gödelisierung(f::Function):: Integer

# surjektiv
degödelisierung(x::Integer):: Function
Wir zeigen zuerst, dass wenn \(A\) aufzählbar ist, \(A ≤_m K\) gilt:
Sei \(A\) eine aufzählbare Menge.
\(⇒ ∃f: ℕ → ℕ\) berechnbar, sodass \(D_f = A\).
function g(x)
    return (gödelisierung(f), x)
end
\(g\) ist damit berechenbar und erfüllt die Bedingung:
\[x ∈ A \; \longleftrightarrow \; g(x) ∈ K\]
Nun zeigen wir, dass \(K ≤_m K_0\) gilt:
Betrachte die berechenbare Funktion \(q:ℕ^2 → ℕ\) das für jedes Paar \((i, y) ∈ ℕ^2\) ein Programm \(M_{q(i,x)}\) konstruieren das \(M_i\) auf der Eingabe \(y\) simuliert und die eigene Eingabe ignoriert. Da für jedes Paar \((i, y) ∈ ℕ^2\) ein solches Programm \(M_{q(i,y)}\) konstuierbar ist, ist \(q\) berechenbar und total:
function q(i, y)
    function f(x)
        M_i::Function = degödelisierung(i)
        return M_i(y)
    end
    return gödelisierung(f)
end
\(q\) erfüllt damit die Bedingung:
\[ (i, y) ∈ K \quad ⟷ \quad q(i, y) ∈ K_0 \]
Die Programme, die eine Funktion in einer Klasse \(\mathcal{F}\) berechnen, bilden die Menge
\[ P(\mathcal{F}) := \{i \mid \text{ RAM } M_i \text{ berechnet eine Funktion in } \mathcal{F}\} \]
Sei \(\mathcal{F} ⊂ \textbf{TM}\) mit \(\mathcal{F} ≠ ∅\). Dann gilt:
Ist \(ν¹ ∈ \mathcal{F}\), so gilt \(\overline{K_0} ≤_m P(\mathcal{F})\)
Ist \(ν¹ ∉ \mathcal{F}\), so gilt \(K_0 ≤_m P(\mathcal{F})\)
Hasse Diagramm zu den \(m\)-Reduktionsklassen:
Satz von Rice (1953)
Jede nichttriviale Eigenschaft von Funktionen ist unentscheidbar.
Es sei \(\mathcal{F} ⊊ \textbf{TM}\) mit \(\mathcal{F} ≠ ∅\) und \(\mathcal{F} ≠ \textbf{TM}\). Dann gilt:
- Ist \(ν^1 ∈ \mathcal{F}\), so ist \(P(\mathcal{F})\) nicht aufzählbar.
- Ist \(ν^1 ∉ \mathcal{F}\), so ist \(\overline{P(\mathcal{F})}\) nicht aufzählbar.
- \(P(\mathcal{F})\) ist unentscheidbar.
⚠️ Die Aussage ist nicht: \(ν^1 ∉ \mathcal{F} \; ⇒ \; P(\mathcal{F})\) ist aufzählbar
Die Menge \[ \overline{P(\{ν^1\})} = \{x \mid \text{ die RAM } M_x \text{ hält auf irgendeiner Eingabe } y ∈ ℕ \} \] ist aufzählbar.
⚠️ Diese Aussage folgt nicht aus dem Satz von Rice
Die Menge \[ P(\{x ↦ x^2\}) = \{x \mid \text{ die RAM } M_x \text{ berechnet } y ↦ y^2 \text{ für jede Eingabe } y ∈ ℕ \} \] ist nicht aufzählbar.
⚠️ Diese Aussage folgt nicht aus dem Satz von Rice
Komplexitätstheorie
Laufzeit von Algorithmen
Sei \(M\) ein Algorithmus der die totale Funktion \(f: (Σ^*)^m → Σ^*\) berechnet.
Laufzeitfunktion:
\[t_M: (Σ^*)^m → ℕ\]
Definition: Laufzeit
Sei \(t: ℕ → ℕ\) eine totale Funktion.
Algorithmus M berechnet \(f:(Σ^*)^m → Σ^*\) in der Zeit \(t\) falls gilt:
- \(M\) berechnet \(f\)
- \(t_M(x_1, ..., x_m) ≤ t(|x_1|, ..., |x_m|)\)
Ein Algorithmus \(M\) berechnet \(f : (Σ^∗)^m → Σ^∗\) in der Zeit \(\mathcal{O}(t)\), falls es ein \(c > 0\) gibt, sodass \(M\) die Funktion \(f\) in der Zeit \(c · t(n) + c\) berechnet.
Ein Algorithmus \(M\) entscheidet \(A ⊆ (Σ^∗)^m\) in der Zeit \(t\) (bzw. \(\mathcal{O}(t)\)), falls \(M\) die charakteristische Funktion \(c_A\) in der Zeit \(t\) (bzw. \(\mathcal{O}(t)\)) berechnet.
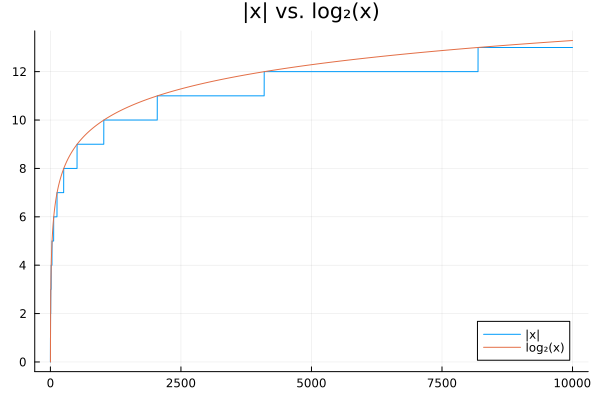
Für jede dyadisch kodierte Zahl \(x\) gilt:
\[ 2^{|x|} - 1 ≤ x ≤ 2^{|x|+1} - 2 \]
zudem gilt:
\[ \log_2(x) ≤ |x| + 1 \]
Laufzeit von RAM Programmen
Jeder Befehl einer RAM ist genau ein Zeitschritt.
Betrachte das RAM Programm \(M\):
# f(x, y, z) = z + x ⋅ y
0   R3 ← 1
# Begin der Schleife
1   IF R1 = 0 GOTO 3
2   R2 ← R2 + R0
3   R1 ← R1 - R3
4   GOTO 1
# Ende der Schleife
5   R0 ← R2
6   STOP
wir sagen, dass die Schleife \(y\)-mal durchlaufen wird.
\[t_M(x,y,z) = 4y + 3\]
y ist muss noch codiert werden, damit wir die Laufzeit in Abhängigkeit von der Eingabelänge angeben können. Dafür brauchen wir \(|y|\) Stellen, also ist \(y ≤ 2^{|y|+1} - 2\).
\[≤ 4 ⋅ 2^{|y|+1} - 8 + 3\] \[≤ 8 ⋅ 2^{|x|+|y|+|z|} - 5 \] \[≤ 8 ⋅ 2^n\]
Laufzeit von Turingmaschinen
Jede Anwendung einer Übergangsfunktion einer Turingmaschine ist genau ein Zeitschritt.
Betrachte die Turingmaschine \(M\) mit einer eingabe \(x\) die die funktion \(S\) berechnet:
- \(z_0\) hat genau \(|x|\) Schritte die auf \(→ z_0\) zeigen.
- \(z_a\) hat \(1 + k\) Schritte, wobei \(k ≤ |x|\) die Anzahl der hinteren 2en im Wort \(x\) ist.
- \(z_b\) hat \(|x| - k\) viele Schritte.
- Auf \(z_1\) zeigt genau ein Schritt, entweder von \(z_a\) oder von \(z_b\).
\[t_M(x) = 1 + |x| + (1+k) + (|x| - k) = 2|x| + 2 ≤ 2n + 2\]
Laufzeit von Höheren Programmiersprachen
- als 0 Schritte zählen 0 intialisierungen. zb
z = 0, A = fill(0, 10, 10) - als ein schritt zählen:
+,-,<,>,≤,≥,==,!=,!,&&,||, Zuweisungen undreturn. - als \(n\) schritte zählen:
*,/,÷
function prod(x,y)
    z = 0 # initialisierung zählt als 0 Schritte
    while (y > 0) # y-mal durchlaufen +1 mal aufgerufen
        z += x # zählt als 2 Schritte
        y -= 1 # zählt als 2 Schritte
    end
    return z # zählt als 1 Schritt
end
\[ \begin{aligned} t_{\text{M}}(x,y) &= 5y + 1 + 1 \\ &≤ 5 ⋅ (2^{|y| + 1} - 2) + 2 \quad (\text{Länge der Codierung})\\ &≤ 5 ⋅ 2^{|y| + 1} - 8 \\ &≤ 10 ⋅ 2^{|x| + |y|} - 8 \\ &≤ 10 ⋅ 2^n - 8 \end{aligned} \]
Die Klasse \(\textbf{P}\)
Ein Algorithmus \(M\) berechnet \(f:(Σ^*)^m → Σ^*\) in Polynomialzeit, falls ein Polynom \[ p(n) = a_0 + a_1n + ... + a_rn^r \] mit \(r, a_0, ..., a_r ∈ ℕ\) gibt, sodass \(M\) die Funktion \(f\) in der Zeit \(p\) berechnet.
Bemerkung: \(Σ^*\) kann mittels \(|Σ|\)-adischer Codierung in polynomieller Zeit in \(ℕ\) kodiert werden.
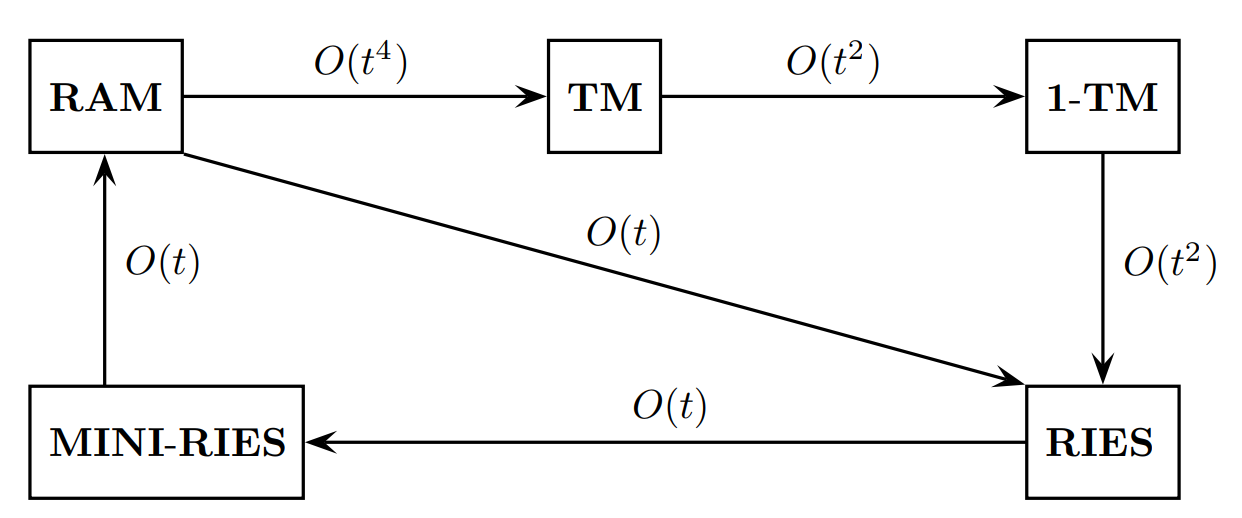
\(f\) ist durch eine RAM in Polynomialzeit berechenbar.
\(⇔\)
\(f\) ist in Julia in Polynomialzeit berechenbar.
\(⇔\)
\(f\) ist durch eine Turingmaschine in Polynomialzeit berechenbar.
\(⇔\)
\(f\) ist durch eine 1-Turingmaschine in Polynomialzeit berechenbar
\[ \textbf{FP} := \{f ∣ f \text{ ist eine in Polynomialzeit berechenbare Funktion}\} \]
\[ \textbf{P} := \{A ∣ A \text{ ist eine in Polynomialzeit entscheidbare Menge}\} \]
- Für alle Mengen \(A\) gilt \(A ∈ \textbf{P} \quad ⇔ \quad c_A ∈ \textbf{FP}\)
- sum, prod, md, div \(∈ \textbf{FP}\)
- \(\textbf{FP}\) ist abgeschlossen unter Hintereinanderausführung und jedem Operator in \(\textbf{FP}\).
- \(\textbf{P}\) ist abgeschlossen unter Komplementbildung, Vereinigung, Durchschnitt.
\(\textbf{FP}\) ist abgeschlossen unter \(\circ, \ZV, \LV, \ID, \SUB\).
Sei \(f: ℕ → ℕ\) eine totale Funktion. Dann gilt:
\[f ∈ \textbf{FP}\]
\[\Leftrightarrow\]
\[∃ p ∈ \textbf{POLY} : |f(x)| ≤ p(|x|) \; ∀x \quad ∧ \quad \{(x,y)\mid y ≤ f(x)\} ∈ \textbf{P}\]
Datentypen (nicht Prüfunsrelevant)
Da wir uns innerhalb der Klasse \(\textbf{FUNK}(ℕ)\) befinden, können wir nur Funktionen \(f: ℕ^n → ℕ\) berechnen. Höhere Datentypen lassen sich jedoch in Polynomialzeit kodieren:
Integer\(≅ ℤ\): bijektiv über \(z(0)=0\), \(z(2n-1)=n\), \(z(2n)=-n\)AbstractFloat\(≅ ℚ = ℤ×ℕ_+\): Kantor-Kodierung von Zähler und NennerString\(≅ Σ^*\): \(|Σ|\)-adische KodierungBool\(≅ \{0,1\}\): \(b(0)=0\), \(b(n)=1\) für \(n>0\)- Tupel/Arrays: mehrfache Anwendung der Kantor-Paarungsfunktion
Als zentrales Hilfsmittel dient die Kantor-Paarungsfunktion, eine bijektive Abbildung \(ℕ^2 \leftrightarrow ℕ\), berechenbar in Polynomialzeit:
# ℕ → ℕ × ℕ (Dekodierung)
function cantor_pairing(z)
    # isqrt ist die ganzzahlige Wurzel in Julia
    w = (isqrt(1 + 8*z) - 1) ÷ 2
    t = w * (w + 1) ÷ 2
    y = z - t
    return (w - y, y)
end

# ℕ × ℕ → ℕ (Kodierung)
function cantor_unpairing(i, j)
    return (i + j) * (i + j + 1) ÷ 2 + j
end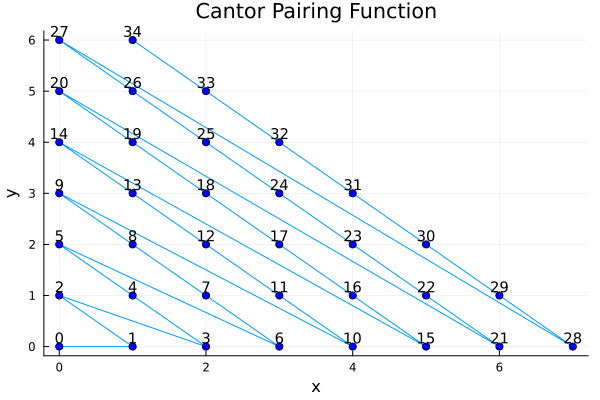
Zusammengesetzte Typen wie
struct Person
    first_name::String
    last_name::String
    age::Integer
    sex::Bool
end
können wir die jeweiligen Felder mit den oben beschriebenen Kodierungen in eine natürliche Zahl kodieren so das wir ein \(ℕ^4\) tupel erhalten, welches wir wiederum mit der Kantor-Paarungsfunktion in eine natürliche Zahl in Polynomialzeit kodieren können.
Nach dem Induktionsprinzip gilt dann:
Jeder zusammengesetzte Datentyp ist in Polynomialzeit in eine natürliche Zahl kodierbar und wieder dekodierbar.
Die Klasse \(\textbf{NP}\)
Eine Menge \(A ⊆ Σ^*\) liegt genau dann in der Klasse \(\textbf{NP}\), wenn ein Polynom \(p\) und eine Menge \(B ∈ \textbf{P}\) existieren, sodass für alle \(x ∈ Σ^*\) gilt:
\[x ∈ A ⟺ (∃y)\;\big[|y| ≤ p(|x|) \; ∧ \; (x, y) ∈ B\big]\]
\[ \textbf{P} ⊆ \textbf{NP} ⊆ \textbf{EXP} ⊆ \textbf{NEXP} \]
Offene Fragen der Komplexitätstheorie
- \(\textbf{P} \stackrel{?}{⊊} \textbf{NP}\)
- \(\textbf{NP} \stackrel{?}{⊊} \textbf{EXP}\)
- \(\textbf{NP} \stackrel{?}{=} \textbf{coNP}\)
- \(\textbf{E} \stackrel{?}{⊊} \textbf{NE}\)
- \(\textbf{EXP} \stackrel{?}{⊊} \textbf{NEXP}\)
- \(\textbf{LINTIME} \stackrel{?}{⊊} \textbf{NLINTIME}\)
Wir wissen aber dass \(\textbf{LINSPACE} ⊊ \textbf{NLINSPACE}\) gilt.
Die Komplexitätsklassen werden durch die Laufzeit einer Turingmaschine definiert, die die Menge entscheidet.
- \(\textbf{LINTIME} ≃ \mathcal{O}(n)\)
- \(\textbf{P} ≃ \mathcal{O}(n^c)\)
- \(\textbf{E} ≃ \mathcal{O}(2^{cn})\)
- \(\textbf{EXP} ≃ \mathcal{O}(2^{n^c})\)
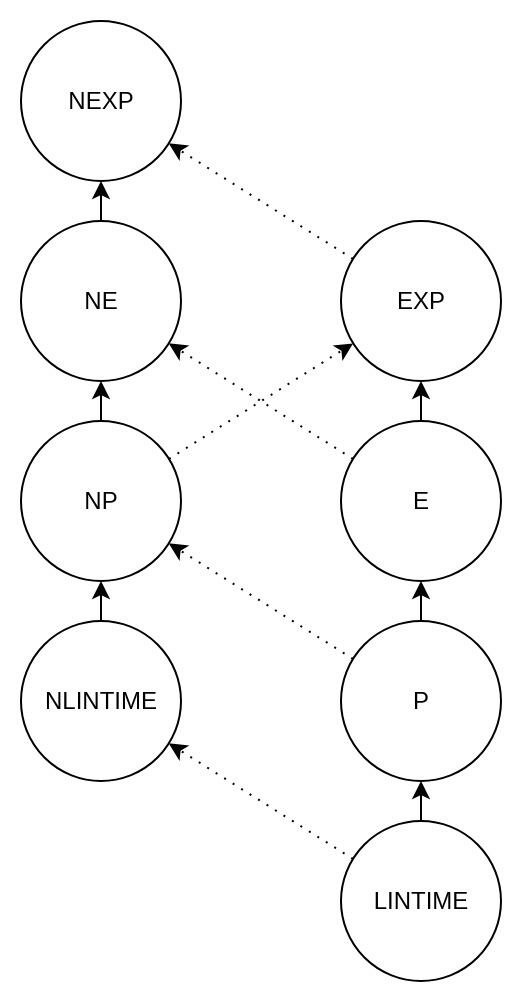
⚠️ In der Literatur wird oft \(\textbf{LIN} := \textbf{LINSPACE}\) definiert!
Mögliche Ergebnisse des \(\textbf{P}\) vs \(\textbf{NP}\) Problems:
- \(\textbf{P}=\textbf{NP}\)
- \(\textbf{P} \subsetneq \textbf{NP}\)
- \(\textbf{P} \stackrel{?}{=} \textbf{NP}\) ist ein gödelsches Problem, d.h. es kann weder bewiesen noch widerlegt werden.
- \(\textbf{P} \subsetneq \textbf{NP}\) ist unabhängig von den Axiomen der Mengenlehre, d.h. es ist selbst ein Axiom.
Nichtdeterministische Maschienen
Wir können an bestimmten Stellen unsere Berechnungsmodelle in mehrere separate Threads aufteilen.
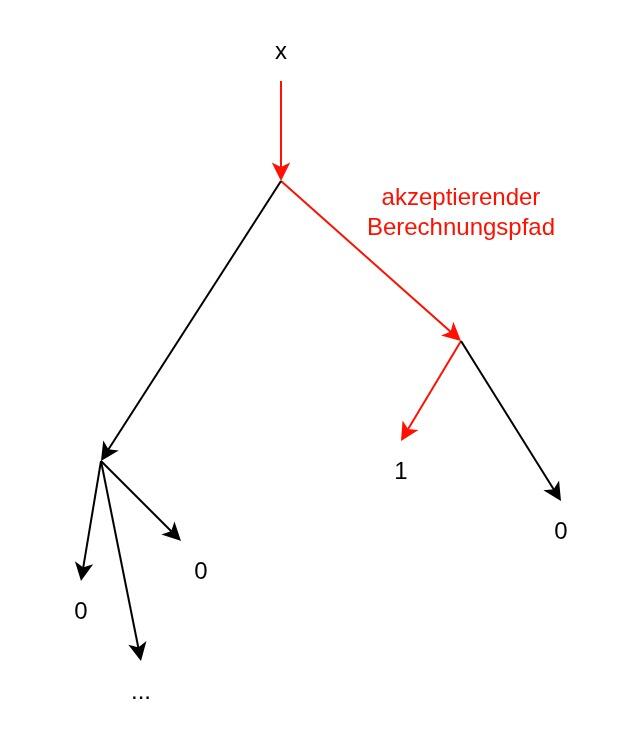
Nichtdeterministische Turingmaschinen
Statt einer Übergangsfunktion \(f: Z × Σ^k → Z × Σ × \{L, 0, R\}\) haben wir eine binäre Übergangsrelation die nicht rechtseindeutig sein muss: \(R ⊆ (Z × Σ^k) × (Z × Σ × \{L, 0, R\})\).
Dadurch können wir für die selbe linke Seite mehrere verschiedene rechte Seiten haben, z.B.
- \(z_1a → z_2b\)
- \(z_1a → z_3c\)
- \(z_1a → z_1a\)
Nichtdeterministische RAMs
Mehrere Befehle können auf die gleiche Zeilennummer zeigen, z.B.:
0   IF R1 = 0 GOTO 2
1   R2 ← R2 + R0
2   R1 ← R1 - 1
# nichtdeterministische Verzweigung
3   STOP
3   GOTO 0
Nichtdeterministische Höhere Programmiersprachen
Wir können in julia ein macro @ndet definieren, das eine nichtdeterministische Verzweigung ermöglicht:
function f(x::Vector{Integer})
    l = length(x)
    result = 0
    for i ∈ 1:l
        # nichtdeterministische Verzweigung mit 3 Threads
        @ndet begin
            result += x[i] |
            result -= x[i] |
            result = result
        end
        if result = 10
            return true
        end
    end
    return false
end
Definition 11
Sei \(M\) ein nichtdeterministischer Algorithmus.
- \(M\) akzeptiert eine Eingabe \(x \in (Σ^*)^m\), falls es einen Berechnungspfad gibt, der mit \(M\) auf der Eingabe \(x\) beginnt und auf dem 1 zurückgegeben wird. Ein Pfad, auf dem 1 zurückgegeben wird, heißt akzeptierender Berechnungspfad.
- \(L(M) := \{x ∈ Σ^* \mid M \text{ akzeptiert } x\}\) heißt die von \(M\) akzeptierte Menge/Sprache.
Definition 12
Sei \(t:ℕ → ℕ\) total und monoton wachsend.
- Ein nichtdeterministischer Algorithmus \(M\) akzeptiert eine Menge \(A ⊆ Σ^*\) in der Zeit \(t\), falls gilt:
- \(L(M) = A\)
- Die Laufzeit jedes Berechnungspfades von \(M\) auf jeder Eingabe \(x\) ist höchstens \(t(|x|)\).
- Ein nichtdeterministischer Algorithmus \(M\) akzeptiert eine Menge \(A ⊆ Σ^*\) in der Zeit \(\mathcal{O}(t)\), falls es ein \(c > 0\) gibt, sodass \(M\) die Menge \(A\) in der Zeit \(c · t(n) + c\) akzeptiert.
Für jede Menge \(A \in \textbf{NP}\) gilt:
\(A\) wird von einem nichtdeterministischen Algorithmus in Polynomialzeit akzeptiert.
\(\textbf{NP}\)-vollständige Mengen
Sein \(A⊆Σ^*_1\) und \(B⊆Σ^*_2\) Mengen. Falls es eine totale Funktion \(f:Σ^*_1 → Σ^*_2\) mit \(f ∈ \textbf{FP}\) gibt \[ x ∈ A \quad ⟷ \quad f(x) ∈ B \] bzw. \[ C_A(x) = C_B(f(x)) \] gibt, so sagen wir: \(A\) ist in Polynomialzeit reduzierbar auf \(B\) bzw. \[ A ≤^p_m B \]
Anmerkung: \(Σ^*\) kann durch die Induzierung einer totalen Ordnung auf den Symbolen \(Σ\) zu einer \(|Σ|\)-adischen kodierung der Natürlichen Zahlen genutzt werden, daher können wir auch \(A, B ⊆ ℕ\) anstatt \(A⊆Σ^*_1\) und \(B⊆Σ^*_2\) schreiben.
- Die Relation \(≤_m^p\) ist reflexiv und transitiv.
- Für alle Mengen \(A\) und \(B\) gilt: \(A ≤_m^p B \quad \Leftrightarrow \quad \overline{A} ≤_m^p \overline{B}\)
\(\textbf{P}\) und \(\textbf{NP}\) sind abgeschlossen unter \(≤_m^p\). Daher
- Ist \(A ≤_m^p B\) und \(B ∈ \textbf{P}\), so ist \(A ∈ \textbf{P}\).
- Ist \(A ≤_m^p B\) und \(B ∈ \textbf{NP}\), so ist \(A ∈ \textbf{NP}\).
Sei \(B ⊊ ℕ\) und \(B ≠ ∅\) (nicht-trivial). Dann gilt: \(A ≤_m^p B\) für alle \(A ∈ \textbf{P}\).
Definition: NP-vollständig
Eine Menge \(B\) heißt NP-vollständig, falls \(B ∈ NP\) und \(A ≤^p_m B\) für alle \(A ∈ \textbf{NP}\).
Definition: NP-schwer
Eine Menge \(B\) heißt NP-schwer, falls \(A ≤^p_m B\) für alle \(A ∈ \textbf{NP}\).
Seien \(A, B ⊆ ℕ\).
- Sind \(A\) und \(B\) \(\textbf{NP}\)-vollständig, so gilt \(A ≡^p_m B\).
- Ist \(A\) \(\textbf{NP}\)-vollständig und \(A ∈ \textbf{P}\), so gilt \(\textbf{P} = \textbf{NP}\).
- Ist \(B ∈ \textbf{NP}\), ist \(A\) \(\textbf{NP}\)-vollständig und \(A ≤^p_m B\), so ist \(B\) \(\textbf{NP}\)-vollständig.
Folgende Mengen sind NP-vollständig:
\[\text{HK} = \{G \mid G \text{ ist ein hamiltonischer Graph }\}\]
Ein Graph \(G\) heißt hamiltonisch, wenn es einen Kreis gibt, der durch alle Knoten genau einmal geht und am Ende wieder zum Startknoten zurückkehrt.
\[ \begin{gathered} \text{SOS} = \\ \{ (a_1, ..., a_n, b) \mid \text{es gibt } I \subseteq [n] \text{ mit } \\ \sum_{i \in I} a_i = b \} \end{gathered} \]
Die SOS-Menge besteht aus Tupeln von Zahlen, für die es eine Teilmenge gibt, deren Summe genau \(b\) ergibt.
\[ \begin{gathered} \text{PARTITION} = \\ \{ (a_1, ..., a_n) \mid \text{ es gibt } I ⊆ [n] \text{ mit } \\ \sum_{i∈I} a_i = \sum_{j∉I} a_j\} \end{gathered} \]
Die PARTITION-Menge besteht aus Tupeln von Zahlen, für die es eine Teilmenge gibt, deren Summe gleich der Summe der restlichen Zahlen ist.
\[ \begin{gathered} 3\text{-FARB} = \\ \{G \mid G \text{ ist ein Graph, der mit } 3 \text{ Farben färbbar ist }\} \end{gathered} \]
Eine Knotenfärbung eines Graphen \(G\) mit 3 Farben ist eine Zuordnung von Farben zu den Knoten von \(G\), sodass benachbarte Knoten unterschiedliche Farben haben. Ein Graph ist 3-färbbar, wenn es eine solche Färbung mit höchstens 3 Farben gibt.
\[ \begin{gathered} 3\text{-SAT} = \\ \{\phi \mid \phi(x_1, ..., x_n) \\ \text{ ist eine erfüllbare Formel in konjunktiver Normalform mit höchstens} \\ 3 \text{ Literalen pro Klausel }\} \end{gathered} \]
Eine Formel in konjunktiver Normalform (CNF) ist eine Konjunktion von Klauseln, wobei jede Klausel eine Disjunktion von Literalen ist. Ein Literal ist entweder eine Variable oder die Negation einer Variable. Eine Formel ist erfüllbar, wenn es eine Belegung der Variablen gibt, die die Formel wahr macht.
z.B die Formel \((x_1 ∨ ¬x_2 ∨ x_3) ∧ (¬x_1 ∨ x_2 ∨ ¬x_3)\) ist in 3-CNF und hat 2 Klauseln mit jeweils 3 Literalen.
\[ \begin{gathered} \text{PUZZLE} = \\ \{ (k, t, R, T_1, \ldots, T_k) \mid k, t \ge 1, R \in (\Sigma)^{4t},\\ T_1, \ldots, T_k \in (\Sigma)^4 \\ \text{ und } R \text{ kann mit Puzzleteilen der Typen } T_1, \ldots, T_k \text{ gefüllt werden} \} \end{gathered} \]
- \(Σ\): Symbolmenge
- \(T_k\): Puzzleteiltyp, definiert durch die 4 Symbole an den Seiten
- \(R\): Puzzle-Region
- \(k\): Anzahl der Puzzleteiltypen
- \(t\): Anzahl der Reihen und Spalten in der Puzzle-Region
Aufgabe: Knoten vs. Kantenfärbung
Das Knotenfärbungsproblem ist definiert als: \[ k\text{-FARB} = \{G \mid G \text{ ist ein Graph, der mit } k \text{ Farben färbbar ist }\} \]
Das Kantenfärbungsproblem ist definiert als: \[ k\text{-KANTENFARB} = \{G \mid G \text{ ist ein Graph, dessen Kanten mit } k \text{ Farben färbbar sind }\} \]
Zeigen Sie, dass \(k\text{-KANTENFARB} ≤_m^p k\text{-FARB}\) gilt.
Lösung
Idee: Wir verwandeln Kanten in Knoten um, sodass benachbarte Kanten in \(G\) zu benachbarten Knoten im neuen Graphen \(G'\) werden. Dann ist die Kantenfärbung von \(G\) äquivalent zur Knotenfärbung von \(G'\).
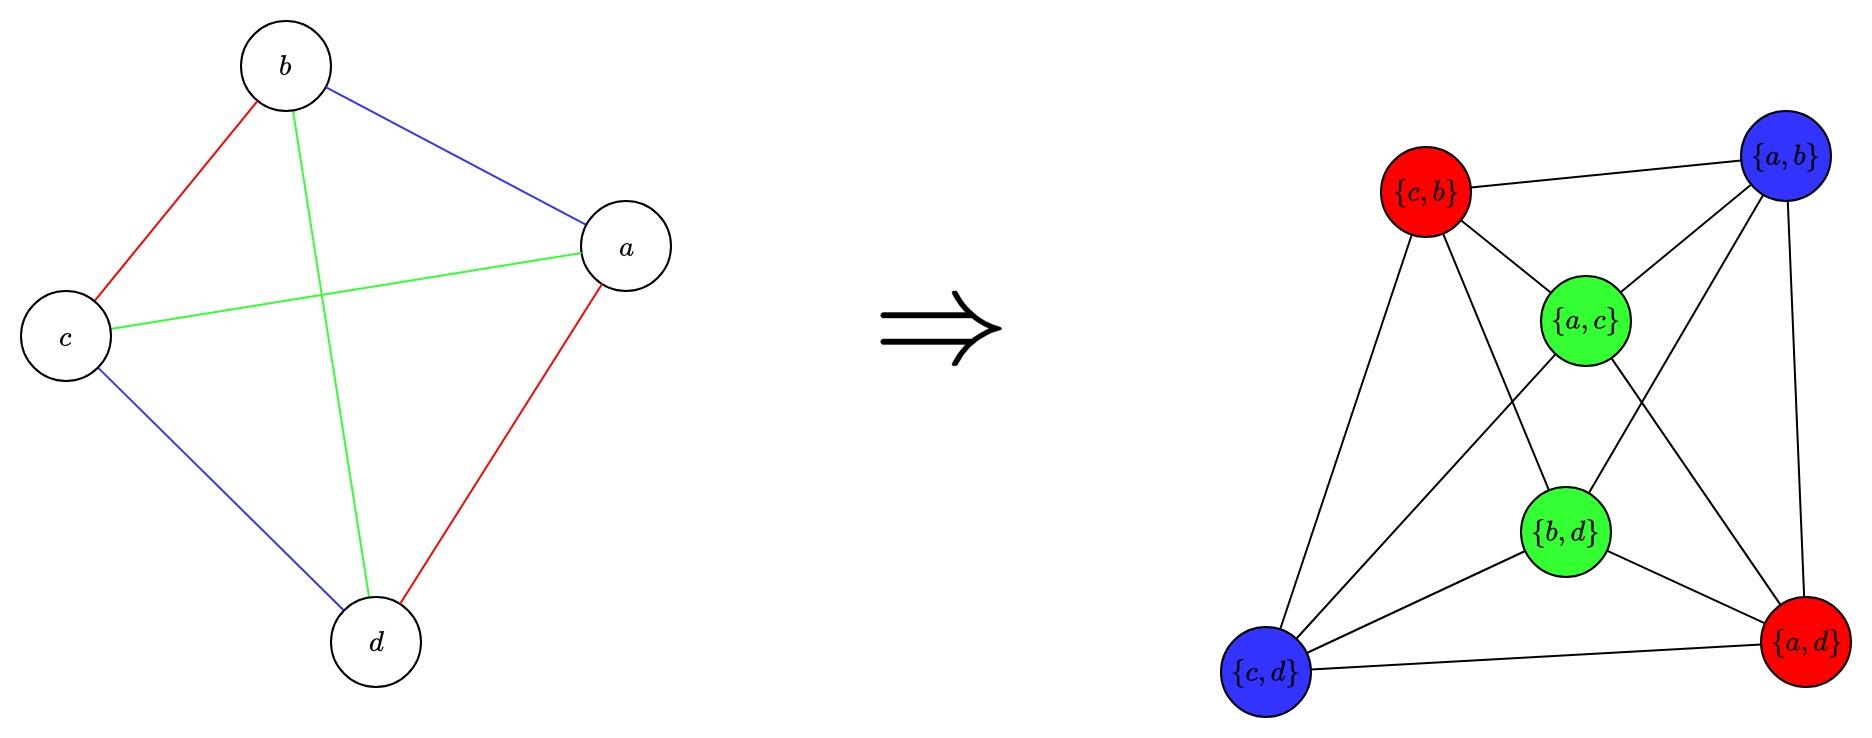
Korrektheit der Reduktion
Der Graph \(G\) ist genau dann k-kantenfärbbar, wenn der Graph \(G'\) k-knotenfärbbar ist, denn jede Kante in \(G\) wird zu einem Knoten in \(G'\), und zwei Kanten in \(G\) teilen genau dann einen Knoten, wenn die entsprechenden Knoten in \(G'\) benachbart sind. Daher kann eine k-kantenfärbung von \(G\) direkt in eine k-knotenfärbung von \(G'\) umgewandelt werden und umgekehrt.
Polynomialzeit der Reduktion
\[ \begin{aligned} &f: \underbrace{(E,V)}_{G} ↦ \underbrace{(E', V')}_{G'} \\ &V' = E \\ &E' = \{(e_1, e_2) ∈ E × E \mid |e_1 ∩ e_2| = 1\} \\ \end{aligned} \]
Wir nehmen an das die Datenstruktur wie folgt aussieht:
struct Graph{Vertex}
    V::Set{Vertex} # Knoten
    E::Set{Set2{Vertex}} # Kanten
end
wobei Set2{Vertex} ein Set mit genau 2 Elementen ist.
Das kann mit folgender Funktion in \(\textbf{FP}\) berechnet werden:
function edge_to_vertex(G::Graph)
    # Get the vertex type
    Vertex::Datatype = typeof(first(G.V))
    E::Set{Set2{Vertex}} = G.E # Kanten von G
    V::Set{Vertex} = G.V # Knoten von G
    E´ = Set{Set2{Set2{Vertex}}}() # Kanten von G´
    for e1 ∈ E # ≤ n-mal
        for e2 ∈ E # ≤ n-mal
            if length(e1 ∩ e2) == 1 # e1 und e2 teilen genau einen Knoten
                push!(E´, Set(e1,e2)) # füge die Kante (e1,e2) zu E´ hinzu
            end
        end
    end
    return Graph(E, E´) # gebe den neuen Graphen G´ zurück
end
Das hat eine Laufzeit von \(\mathcal{O}(n^2)\) und ist damit in \(\textbf{FP}\).
somit gilt: \(k\text{-KANTENFARB} ≤_m^p k\text{-FARB}\).
Aufgabe: 3-Sat vs. “Independent Set”
Sie kennen bereits das 3-Sat Problem: \[ \begin{gathered} 3\text{-SAT} = \\ \{\phi \mid \phi(x_1, ..., x_n) \\ \text{ ist eine erfüllbare Formel in konjunktiver Normalform mit höchstens} \\ 3 \text{ Literalen pro Klausel }\} \end{gathered} \]
Das “Independent Set” Problem ist definiert als: \[ \text{IS} = \{ (G, k) \mid G \text{ enthält eine unabhängige Menge mit mindestens } k \text{ Knoten} \} \]
Wobei eine unabhängige Menge in einem Graphen \(G\) eine Teilmenge von Knoten ist, bei der keine zwei Knoten durch eine Kante verbunden sind.
Zeigen Sie, dass \(\text{3-SAT} ≤_m^p \text{IS}\) gilt.
Lösung
Wir sagen wir haben \(m\) Klauseln. \[ \phi = C_1 ∧ C_2 ∧ ... ∧ C_m \]
Wir verwandeln jedes Literal in einen Knoten (auch wenn es die selbe variable mehrmals vorkommt), so dass wir genau \(3m\) Knoten haben.
Wir verbinden alle Knoten,
- die in der selben Klausel vorkommen, miteinander, sodass wir genau \(m\) Dreiecke haben.
- die Knoten, die sich gegenseitig negieren, miteinander, sodass wir keine unabhängige Menge haben können, die sowohl \(x_i\) als auch \(\neg x_i\) enthält.
zum Beispiel die Formel: \[ \phi = \underbrace{(x_1 ∨ ¬x_2 ∨ x_3)}_{C_1} ∧ \underbrace{(¬x_1 ∨ x_2 ∨ x_3)}_{C_2} ∧ \underbrace{(x_2 ∨ ¬x_3 ∨ ¬x_4)}_{C_3} \] wird zu folgendem Graphen \(G\) transformiert:
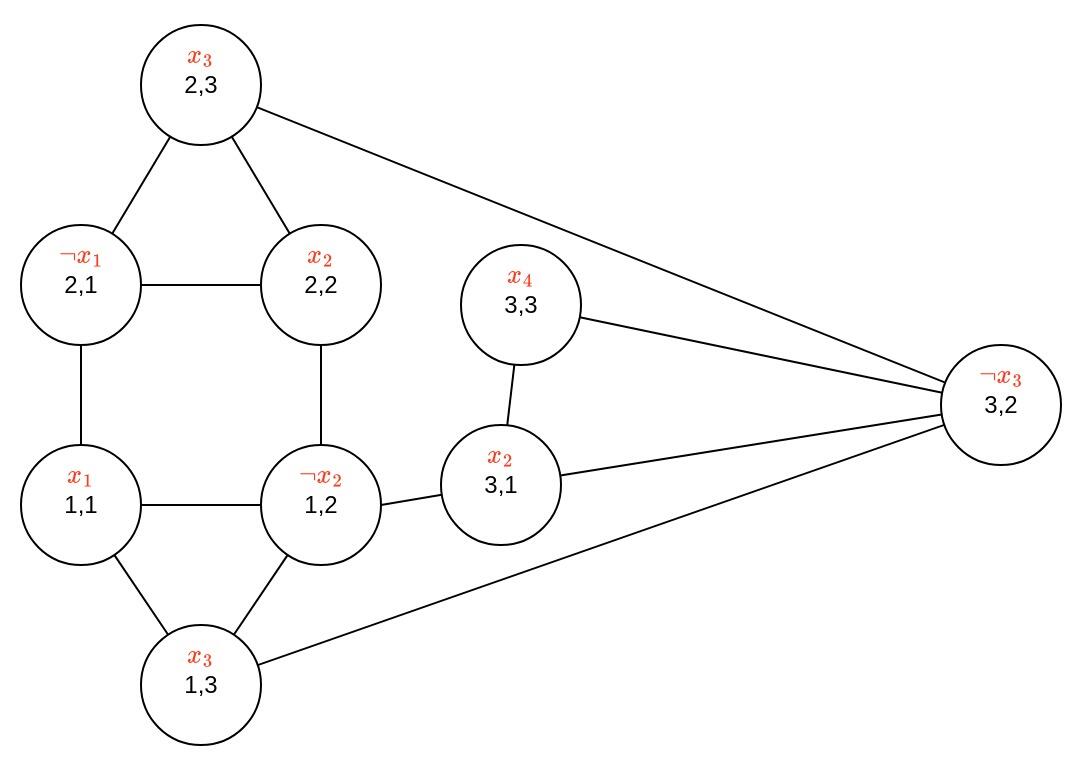
Wenn wir nun \(k = m\) wählen, haben wir eine polynomielle Reduktion von 3-SAT auf Independent Set konstruiert, den Das Independent Set wäre dann genau eine Lösung für die 3-SAT Formel.
Korrektheit der Reduktion
Eine unabhängige Menge der Größe \(m\) im Graphen \(G\) entspricht genau einer erfüllbaren Belegung der Klauseln in der 3-SAT-Formel. Jede Klausel muss genau ein Literal enthalten, das in der unabhängigen Menge ausgewählt wird, was bedeutet, dass dieses Literal wahr ist. Da keine zwei Knoten in der unabhängigen Menge durch eine Kante verbunden sind, kann kein Literal und sein Negation gleichzeitig ausgewählt werden, was die Konsistenz der Belegung sicherstellt.
Polynomielle Laufzeit der Reduktion
Wir gehen davon aus dass die Formel wie folgt aufgebaut ist:
struct Formula
# m × 3 Matrix von Literalen
clauses::Matrix{Literal}
endWobei Literal irgendein Datentyp ist, der == und ¬ nach gesundem Menschenverstand implementiert.
Wir nehmen an das die Datenstruktur für den Graphen wie folgt aussieht:
struct Graph{Vertex}
    V::Set{Vertex} # Knoten
    E::Set{Set2{Vertex}} # Kanten
end
wobei Set2{Vertex} ein Set mit genau 2 Elementen ist.
Die Reduktionsfunktion kann dann wie folgt implementiert:
function sat_to_is(φ::Formula)
# φ = (C_1 ∧ C_2 ∧ ... ∧ C_m)
k = size(φ.clauses)[1] # Anzahl der Klauseln
Vetex::Datatype = Tuple{Int,Int}
V´ = Set{Vetex}() # Knotenmenge von G´
E´ = Set{Set2{Vetex}}() # Kantenmenge von G´
# Erstelle Knoten für jedes Literal in jeder Klausel
for i ∈ 1:k # ≤ k-mal
for j ∈ 1:3 # ≤ 3-mal
v = (i,j)
push!(V´, v) # füge den Knoten v zu V´ hinzu
# Verbinde alle Knoten in der selben Klausel miteinander
for l ∈ 1:3 # ≤ 3-mal
if l != j
# füge die Kante (v, (i,l)) zu E´ hinzu
push!(E´, Set2(v, (i,l)))
end
end
# Verbinde alle Knoten, die sich gegenseitig negieren
for l ∈ 1:k # ≤ k-mal
for m ∈ 1:3 # ≤ 3-mal
u = (l,m)
if φ.clauses[i][j] == ¬φ.clauses[l][m]
# füge die Kante (v, u) zu E´ hinzu
push!(E´, Set2(v, u))
end
end
end
end
return Graph(V´, E´), k # gebe den neuen Graphen G´ und k zurück
endDieser Algorithmus hat eine Laufzeit von \(\mathcal{O}(n^2)\) und ist damit in \(\textbf{FP}\).
Somit gilt: \(\text{3-SAT} ≤_m^p \text{IS}\).
Aufgabe: \(\text{VC} ≤_m^p \text{FVS}\)
Das Vertex Cover Problem ist definiert als: \[ \text{VC} = \{ (G, k) \mid G \text{ enthält eine Knotenüberdeckung mit höchstens } k \text{ Knoten} \} \] eine Knotenüberdeckung in einem Graphen \(G\) ist eine Teilmenge von Knoten, sodass jede Kante in \(G\) mindestens einen Endknoten in der Teilmenge hat.
Das Feedback Vertex Set Problem ist definiert als: \[ \text{FVS} = \{ (G, k) \mid G \text{ enthält eine Feedback-Knotenmenge mit höchstens } k \text{ Knoten} \} \] eine Feedback-Knotenmenge in einem Graphen \(G\) ist eine Teilmenge von Knoten, sodass das Entfernen dieser Knoten aus \(G\) einen azyklischen (kreisfreien) Graphen ergibt.
Zeigen Sie, dass \(\text{VC} ≤_m^p \text{FVS}\) gilt.
Lösung
Geben ist der Input für das Vertex Cover Problem: Ein Graph \(G = (V, E)\) und eine Zahl \(k\).
Bemerke: Haben wir eine Knotenüberdeckung und entfernen diese Knoten aus dem Graphen, so haben wir sicherlich keine Kreise mehr.
Idee: Wir verwandeln jede Kante in einen Kreis, indem wir einen neuen Knoten für jede Kante hinzufügen.
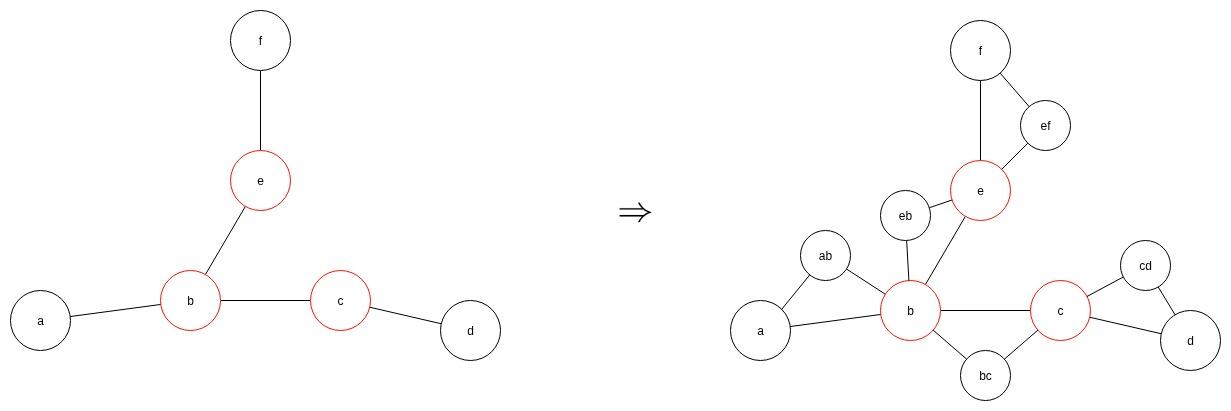
Korrektheit der Reduktion
- \(⇒\) Haben wir zuvor eine Knotenüberdeckung mit höchstens \(k\) Knoten, so ist diese nach anwendung der Reduktionsfunktion genau auch eine Feedback-Knotenmenge mit höchstens \(k\) Knoten.
- \(⇐\) Haben wir nach anwendung der Reduktionsfunktion eine Feedback-Knotenmenge mit höchstens \(k\) Knoten, kann ich falls irgendwelche der neuen Knoten in der Feedback-Knotenmenge sind, diese durch einen der Endknoten der Kante ersetzen, sodass wir eine Knotenüberdeckung mit höchstens \(k\) Knoten erhalten.
Polynomialzeit der Reduktion
Wir nehmen an das die Datenstruktur wie folgt aussieht:
struct Graph{Vertex}
    V::Set{Vertex} # Knoten
    E::Set{Set2{Vertex}} # Kanten
endDann sieht die Reduktionsfunktion wie folgt aus:
function vc_to_fvs(G::Graph, k::Int)
    # Get the vertex datatype
    Vertex::Datatype = typeof(first(G.V))
    # Copy the vertices and edges of G
    V´::Set{Vertex} = G.V
    E´::Set{Set2{Vertex}} = G.E
    # füge für jede Kante einen neuen Knoten hinzu
    for e ∈ G.E # ≤ n-mal
        # mache aus den Knoten der Kante e einen neuen Knoten v_e
        v_e::Vertex = join(e)
        push!(V´, v_e) # füge den neuen Knoten v_e zu V´ hinzu
        # füge Kanten von v_e zu den Endknoten der Kante e hinzu
        for v ∈ e # ≤ 2-mal
            push!(E´, Set(v_e,v)) # füge die Kante (v_e,v) zu E´ hinzu
        end
    end
    return Graph(V´, E´), k # gebe den neuen Graphen G´ und k zurück
end
Dieser Algorithmus hat eine Laufzeit von \(\mathcal{O}(n)\) und ist damit in \(\textbf{FP}\).
Somit gilt: \(\text{VC} ≤_m^p \text{FVS}\).
Automatentheorie
Endliche Automaten
Definition: DEA
Ein deterministischer endlicher Automat (DEA) ist ein 5-Tupel \(A = (Σ, Z, f, z_0, Z')\), bestehend aus:
- \(Σ\): einem endlichen, nichtleeren, Eingabealphabet
- \(Z\): einer endlichen, nichtleeren, Zustandsmenge
- \(f: Z × Σ → Z\): einer totalen Überführungsfunktion
- \(z_0 ∈ Z\): einem Startzustand
- \(Z' ⊆ Z\): einer Menge von Endzuständen
Die erweiterte Übergangsfunktion \(\overline{f}: Z' × Σ^* → Z\) ist induktiv definiert durch: \[ \begin{aligned} \overline{f}(z, ε) &:= z & \forall z ∈ Z \\ \overline{f}(z, xa) &:= f(\overline{f}(z, x), a) & ∀ z ∈ Z, x ∈ Σ^*, a ∈ Σ \\ \end{aligned} \]
- Ein Wort \(x ∈ Σ^*\) heißt von \(A\) akzeptiert, falls \(\overline{f}(z_0, x) ∈ Z'\).
- \(L(A) = \{x ∈ Σ^* ∣ \overline{f}(z_0, x) ∈ Z'\}\) heißt die von \(A\) akzeptierte Wortmenge.
\[ \textbf{DEA} = \{ L(A) \mid A \text{ ist ein deterministischer endlicher Automat}\} \]
Graphische Darstellung von Endlichen Automaten
- Zustände werden als Kreise dargestellt wobei der Name des Zustands in den Kreis geschrieben wird.
- Pfeile zeigen die Übergänge zwischen Zuständen an.
- Der Startzustand wird doppelt umkreist.
- Endzustände haben ein Rechteck um sich herum.
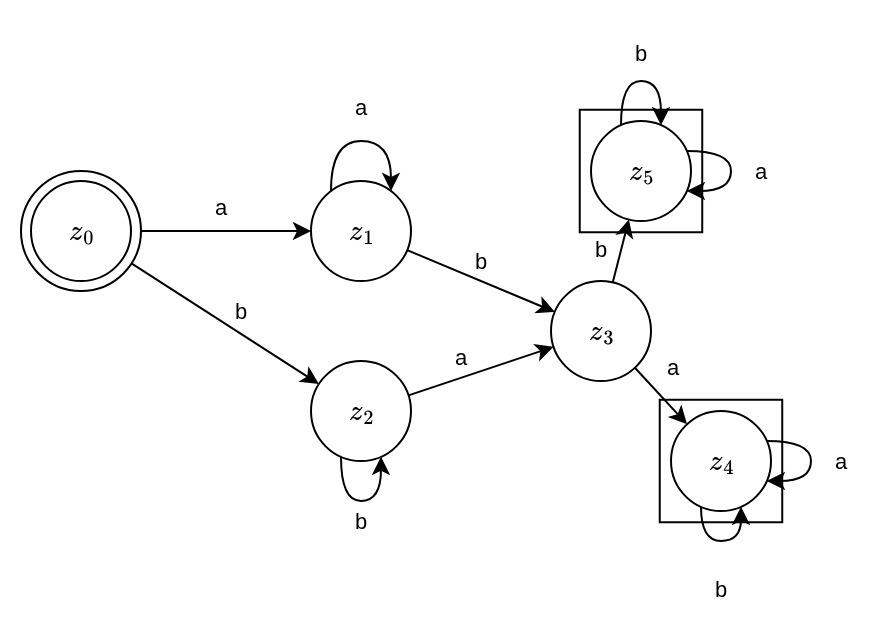
Definition: NEA
Ein nichtdeterministischer endlicher Automat (NEA) ist ein 5-Tupel \(A = (Σ, Z, f, z_0, Z')\), bestehend aus:
- \(Σ\): einem endlichen, nichtleeren, Eingabealphabet
- \(Z\): einer endlichen, nichtleeren, Zustandsmenge
- \(f: Z × Σ → \mathcal{P}(Z)\): einer totalen Überführungsfunktion
- \(z_0 ∈ Z\): einem Startzustand, (manchmal auch mehrere Startzustände erlaubt)
- \(Z' ⊆ Z\): einer Menge von Endzuständen
Die erweiterte Übergangsfunktion \(\overline{f}: Z' × Σ^* → Z\) ist induktiv definiert durch: \[ \begin{aligned} \overline{f}(z, ε) &:= \{z\} & \forall z ∈ Z \\ \overline{f}(z, xa) &:= \bigcup_{z' ∈ \overline{f}(z, x)} f(z', a) & ∀ z ∈ Z, x ∈ Σ^*, a ∈ Σ \\ \end{aligned} \]
- Ein Wort \(x ∈ Σ^*\) heißt von \(A\) akzeptiert, falls \(\overline{f}(z_0, x) ∩ Z' ≠ ∅\).
- \(L(A) = \{x ∈ Σ^* ∣ \overline{f}(z_0, x) ∩ Z' ≠ ∅\}\) heißt die von \(A\) akzeptierte Wortmenge.
\[ \textbf{NEA} = \{L(A) \mid A \text{ ist ein nichtdeterministischer endlicher Automat}\} \]
Theorem 5.2.3 \[ \textbf{DEA} = \textbf{NEA} \]
Aufgabe: NEA to DEA
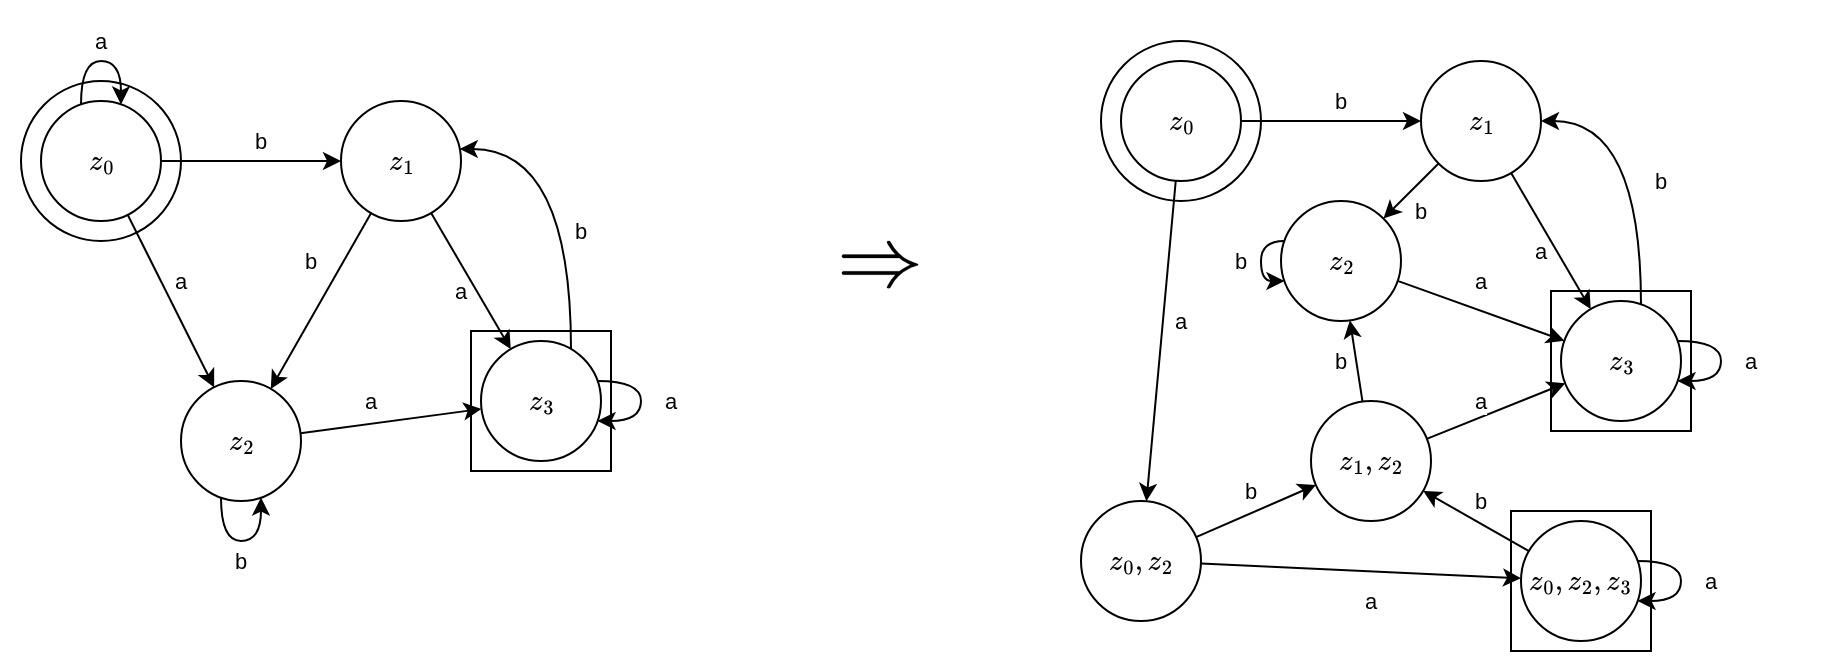
\[ A = (\underbrace{\{a,b\}}_{Σ}, \underbrace{\{z_0, z_1, z_2, z_3\}}_{Z}, f, z_0, \underbrace{\{z_3\}}_{Z'}) \]
wobei wir für \(z0\) einen nichtdeterministischen Übergang haben: \[ f(z_0, a) = \{z_0, z_2\} \]
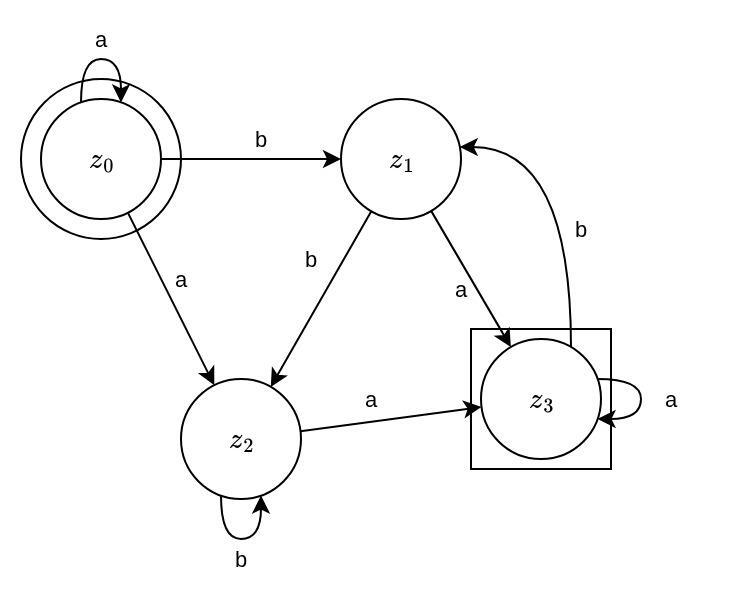
Verwandeln Sie den NEA in einen equivalenten DEA.
Lösung:
Theorem 5.2.4
Seien \(L_1, L_2 ∈ \textbf{DEA}\), so gilt:
- \(L_1 ∪ L_2 ∈ \textbf{DEA}\)
- \(L_1 ∩ L_2 ∈ \textbf{DEA}\)
- \(\overline{L_1} ∈ \textbf{DEA}\)
- \(L_1 ⋅ L_2 ∈ \textbf{DEA}\)
- \(L_1^* ∈ \textbf{DEA}\)
Reguläre Mengen
Definition: Reguläre Menge
Die regulären Mengen über einem Alphabet \(Σ\) sind wie folgt induktiv definiert:
- IA: \(\emptyset,\{a\} \; ∀ a ∈ Σ\) sind regulär
- IS: Sind \(L_1\) und \(L_2\) regulär, so sind auch \(L_1 ∪ L_2\), \(L_1 ⋅ L_2\) und \(L_1^*\) regulär.
bzw. \(Γ(Σ, ∅)_{∪,⋅,^*}\)
Eine Wortmenge/Sprache \(L\) heißt regulär, falls \(L = Γ(Σ, ∅)_{∪,⋅,^*}\) für ein geeignetes Alphabet \(Σ\) gilt.
\[ \textbf{REG} = \{L \mid L \text{ ist eine reguläre Menge}\} \]
Aufgabe: Reguläre Mengen und Automaten
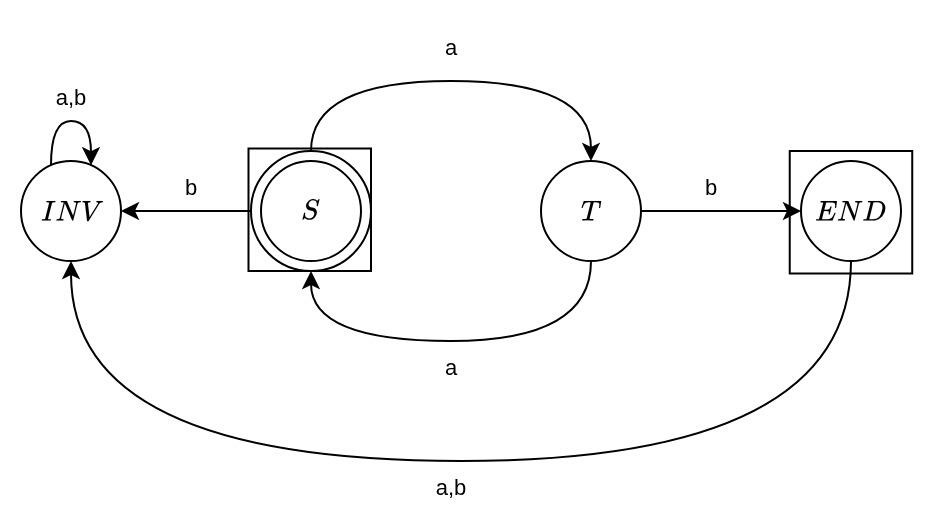
Gegeben sei folgender reguläre Ausdruck: \((aa)^* ∪ a(aa)^*b\)
Geben Sie einen DEA an, der diesen regulären Ausdruck akzeptiert.
Lösung:
A = (\(\underbrace{\{a,b\}}_{Σ}\), \(\underbrace{\{S, T, INV, END\}}_{Z}, f, \underbrace{S}_{z_0}, \underbrace{\{S,END\}}_{Z'})\)
und die Überführungsfunktion \(f\) ist wie folgt definiert:
Regex (nicht Prüfungsrelevant)
In der Informatik werden reguläre Ausdrücke (Regex) verwendet, um Muster in Zeichenketten zu beschreiben. Sie sind eng mit endlichen Automaten und regulären Mengen verbunden.
a|bc: Entweder ‘a’ oder ‘bc’.ab: ‘a’ gefolgt von ‘b’.a*: Null oder mehr aufeinanderfolgende ’a’s.(ab): ‘a’ gefolgt von ‘b’ als eine feste Gruppe.
Mit den erweiterten Operatoren können wir noch einfacher Muster beschreiben:
a+: Ein oder mehrere aufeinanderfolgende ’a’s.a?: Null oder ein ‘a’.a{n}: Genau n aufeinanderfolgende ’a’s.a{n,}: Mindestens n aufeinanderfolgende ’a’s.a{n,m}: Mindestens n und höchstens m aufeinanderfolgende ’a’s.[abc]: Ein einzelnes Zeichen, das entweder ‘a’, ‘b’ oder ‘c’ ist.[a-z]: Ein einzelnes Zeichen, das ein Kleinbuchstabe von ‘a’ bis ‘z’ ist.[^abc]: Ein einzelnes Zeichen, das weder ‘a’, ‘b’ noch ‘c’ ist.
⚠️ Moderne Regex-Implementierungen unterstützen auch erweiterte Funktionen die nicht mehr zu den Regulären Mengen gehören, wie
- Lookahead/Lookbehind mit variablen Langen, z.B.
(?=...)und(?<=...) - Referenzen, z.B.
\1,\2, etc.
Lemma 5.3.2
Seien \(B, C ⊆ Σ^*\).
Falls \(ε ∉ B\), so ist \(L = B^* ⋅ C\) die einzige Lösung der Gleichung \(L = B ⋅ L ∪ C\).
Algorithmus EA → REG
Schreibe jeden \(z\) Zustand als eigene Sprachgleichung \(L_z\):
\[ \begin{gathered} (z,a) → z_a \quad ∧ \quad (z,b) → z_b \\ ⇒ \\ L_z = \{a\} ⋅ L_{z_a} ∪ \{b\} ⋅ L_{z_b} ∪ \begin{cases} \{ε\} & \text{falls } z ∈ Z' \\ \emptyset & \text{sonst} \end{cases} \end{gathered} \]
Löse dann mit dem Lemma 5.3.2 die Gleichungen, nach \(L_{z_0}\) auf. \(L_{z_0}\) ist dann die Sprache, die vom Automaten akzeptiert wird.
Aufgabe: EA → REG
Finde mittels dem EA → REG Algorithmuses einen regülären Ausdruck der den folgenden Automaten beschreibt:
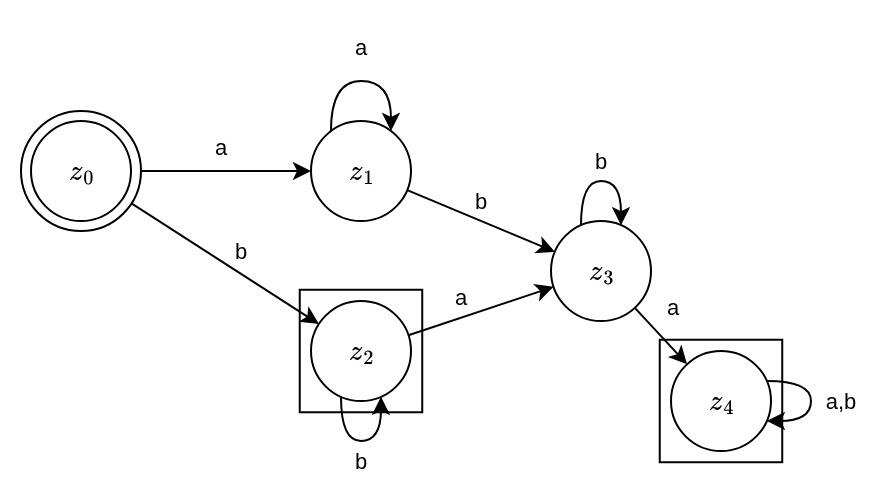
Um die Gleichungen übersichtlicher zu gestalten, können sie die Mengenklammern sowie \(\cdot\) weglassen.
- stellen sie die Gleichungen für jeden Zustand auf.
- lösen sie die Gleichungen, so dass sie einen regulären Ausdruck für die Sprache erhalten, die vom Automaten akzeptiert wird.
Theorem 5.3.3
\[ \textbf{REG} = \textbf{DEA} = \mathcal{L}_3 \]
Pumping-Lemma für reguläre Sprachen:
Für alle \(L ∈ \mathcal{L}_3\) gilt:
\[ \exists n_0 \in \mathbb{N} : \forall x \in L, |x| ≥ n_0, \; \exists u,v,w : x = uvw \]
mit
- \(|uv| ≤ n_0\)
- \(|v| ≥ 1\)
- \(uv^iw ∈ L\) für alle \(i ≥ 0\)
Nutzung des Pumping-Lemmas
Zeige, dass eine Sprache \(L\) nicht regulär oder nicht kontextfrei ist, indem du das Pumping-Lemma anwendest:
- Angenommen \(L ∈ \mathcal{L}_3\) oder \(L ∈ \mathcal{L}_2\) (im kontextfreien Fall). Dann müsste nach dem Pumping-Lemma gelten:
- Wähle ein Wort/Worfunktion \(x_f:ℕ → L\) mit \(x_f(n_0)=x ∈ L\) und \(|x| ≥ n_0, \quad ∀ n_0\).
- Zeige, dass für diese Wort \(x\) nicht alle Regeln des Pumping-Lemmas erfüllt werden können.
Korollar 5.4.2
\[ \textbf{DEA} ⊂ \textbf{P} \]
Pushdown-Automaten (nicht Prüfungsrelevant)
Definition: DPDA (deterministischer Pushdown-Automat)
Ein deterministischer Pushdown-Automat (DPDA) ist ein 6-Tupel \(A = (Σ, Γ, Z, f, z_0, Z')\), bestehend aus:
- \(Σ\): einem endlichen, nichtleeren, Eingabealphabet
- \(Γ\): einem endlichen, nichtleeren, Stackalphabet
- \(Z\): einer endlichen, nichtleeren, Zustandsmenge
- \(f: Z × (Σ ∪ \{ε\}) × (Γ ∪ \{ε\}) → Z × (Γ ∪ \{ε\})\): einer Übergangsfunktion
- \(z_0 ∈ Z\): einem Startzustand
- \(Z' ⊆ Z\): einer Menge von Endzuständen
Definition: NPDA (nichtdeterministischer Pushdown-Automat)
Ein nichtdeterministischer Pushdown-Automat (NPDA) ist ein 7-Tupel \(A = (Σ, Γ, Z, f, z_0, z_s, Z')\), bestehend aus:
- \(Σ\): einem endlichen, nichtleeren, Eingabealphabet
- \(Γ\): einem endlichen, nichtleeren, Stackalphabet
- \(Z\): einer endlichen, nichtleeren, Zustandsmenge
- \(f: Z × (Σ ∪ \{ε\}) × (Γ ∪ \{ε\}) → \mathcal{P}(Z × (Γ ∪ \{ε\}))\): einer Übergangsfunktion
- \(z_0 ∈ Z\): einem Startzustand
- \(z_s ∈ Z\): einem Stackstartzustand
- \(Z' ⊆ Z\): einer Menge von Endzuständen
\[ \textbf{DPDA} ⊊ \textbf{NPDA} = \mathcal{L}_2 \]
Mann nennt die Sprachen die von einem \(\textbf{DPDA}\) entschieden werden deterministisch kontextfreie Sprachen und es gilt:
\[ \textbf{DCFL} = \mathcal{L}_{2.5} = \textbf{DPDA} \]
Theorie der formalen Sprachen
Die Chomsky-Hierarchie
Definition: Generative Gramatik
Ein Tupel \(G = (\Sigma, N, S, R)\) heißt (generative) Grammatik, falls gilt:
- \(\Sigma\): ein endliches, nichtleeres Terminalalphabet
- \(N\): eine endliche, nichtleere Nichtterminalalphabet
- \(S ∈ N\): ein Startsymbol
- \(R ⊆ (Σ ∪ N)^+ × (Σ ∪ N)^*\): eine endliche binäre Relation von Erzeugungsregeln. Diese ist nicht rechtseindeutig, d.h. es kann mehrere Regeln mit demselben linken Teil geben, dh. ist keine Funktion!
Sei G = \((\Sigma, N, S, R)\) eine Grammatik.
- Ein Wort \(w ∈ (Σ ∪ N)^*\) heißt von \(G\) aus \(v ∈ (Σ ∪ N)^+\) in einem Schritt erzeugt, falls \((v, w) ∈ R\). Wir schreiben das auch als:
- \(v ⇒_G w\)
- Ein Wort \(w ∈ (Σ ∪ N)^*\) heißt von \(G\) aus \(v ∈ (Σ ∪ N)^+\) in \(t\) Schritten erzeut falls es Wörter \(v_0, v_1, ..., v_t\) gibt mit \(v_0 = v\), \(v_t = w\) und \(v_{i-1} ⇒_G v_i\) für alle \(i ∈ \{1, ..., t\}\). Wir schreiben das auch als:
- \(v ⇒^t_G w\)
- Ein Wort \(w ∈ (Σ ∪ N)^*\) heißt von \(G\) aus \(v ∈ (Σ ∪ N)^+\) erzeugt, falls es ein \(t ∈ ℕ\) gibt, sodass \(v ⇒^t_G w\). Wir schreiben das auch als:
- \(v ⇒^*_G w\)
- \(L(G) = \{w ∈ Σ^* ∣ S ⇒^*_G w\}\) heißt die von \(G\) erzeugte Sprache.
Definition: Grammatikstypen
Sei \(G = (Σ, N, S, R)\) eine Grammatik.
Im folgenden seien \(w ∈ (Σ ∪ N)^+, \; u, u_1, u_2 ∈ (Σ ∪ N)^*, \; a ∈ Σ\) und \(A,B ∈ N\) beliebig.
\(G\) ist vom Typ 0 oder eine unbeschränkte Grammatik, falls keine Einschränkung an die Regeln in \(R\) gestellt wird.
\(G\) ist vom Typ 1 oder eine kontextsensitive Grammatik, falls für alle \((v, w) ∈ R\) gilt: \(|v| ≤ |w|\). Daher sind nur Regeln folgender Form erlaubt:
- \(u_1Au_2 → u_1wu_2\)
- \(S → ε\)
\(G\) ist vom Typ 2 oder eine kontextfreie Grammatik, falls für alle \((v, w) ∈ R\) gilt: \(v ∈ N\). Daher sind nur Regeln folgender Form erlaubt:
- \(A → u\)
\(G\) ist vom Typ 3 oder eine (strenge) rechtslineare Grammatik, falls für alle \((v, w) ∈ R\) gilt: \(v ∈ N\) und \(w ∈ ΣN ∪ \{ε\}\). Daher sind nur Regeln folgender Form erlaubt:
- \(A → aB\)
- \(A → ε\)
\(G\) ist eine (allgemeine) rechtslineare Grammatik, falls Regeln folgender Form erlaubt sind:
- \(A → wB\)
- \(A → w\)
mit \(w ∈ Σ^*\) und \(A,B ∈ N\).
Jede allgemeine rechtslineare Grammatik kann in eine (strenge) rechtslineare Grammatik umgewandelt werden, die dieselbe Sprache erzeugt.
Definition: Sprachklassen
\[ \mathcal{L}_i = \{L(G) ∣ G \text{ ist eine Grammatik vom Typ } i\} \]
unterander gilt:
\[ \mathcal{L}_3 ⊂ \mathcal{L}_2 ⊂ \mathcal{L}_1 ⊂ \mathcal{L}_0 \]
- \(\mathcal{L}_3 =\textbf{EA} = \textbf{NEA}\)
- \(\mathcal{L}_2 =\textbf{NPDA}\)
- \(\mathcal{L}_1 =\textbf{NLINSPACE} \subseteq \textbf{E}\)
- \(\mathcal{L}_0 =\textbf{RE}\)
Aufgabe: Simple-Gramatik
Gegeben sei folgende Grammatik: \[ G = (\underbrace{\{0,1\}}_{Σ}, \underbrace{\{S, A, B, C\}}_{N}, S, R) \] wobei die Regeln \(R\) wie folgt definiert sind: \[ \begin{aligned} S &→ 0S \; | \; 1A \\ A &→ 0B \; | \; 1A \\ B &→ 0S \; | \; 1C \\ C &→ 0C \; | \; 1C \; | \; ε \end{aligned} \]
- Zu welcher Sprachklasse gehört die Sprache \(L(G)\)?
- Geben sie einen Automaten/Maschine an, der die Sprache \(L(G)\) akzeptiert.
Lösung:
Wir konstruieren nun von den Gramatikregeln einen DEA:
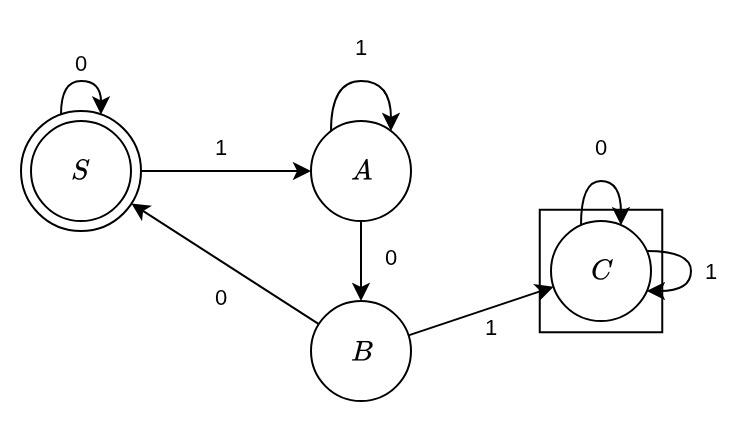
Aufgabe: SUS-Gramatik
Gegeben sei folgende Grammatik: \[ G = (\underbrace{\{a,b\}}_{Σ}, \underbrace{\{S, A, T\}}_{N}, S, R) \] wobei die Regeln \(R\) wie folgt definiert sind: \[ \begin{aligned} S &→ AT \; | \; ε \\ T &→ AS \; | \; b \\ A &→ a \end{aligned} \]
- Zu welcher Sprachklasse gehört die Sprache \(L(G)\)?
- Geben sie einen Automaten/Maschine an, der die Sprache \(L(G)\) akzeptiert.
Lösung:
Wir konstruieren nun von den Gramatikregeln einen DEA:
Kontextfreie Sprachen
Pumping-Lemma für kontextfreie Sprachen:
Für alle \(L ∈ \mathcal{L}_2\) gilt:
\[ \exists n_0 \in \mathbb{N} : \forall z \in L, |z| ≥ n_0, \; ∃u,v,w,x,y: z = uvwxy \]
mit
- \(|vwx| ≤ n_0\)
- \(|vx| ≥ 1\)
- \(uv^iwx^iy ∈ L\) für alle \(i ≥ 0\)
Chomsky-Normalform
Definition: Chomsky-Normalform
Sei \(G = (Σ, N, S, R)\) eine Gramatik. Falls \(G\) nur Regeln der Form:
\[ \begin{aligned} S &→ ε \\ A &→ BC\\ A &→ a \end{aligned} \]
wobei \(A,B,C ∈ N\) und \(a ∈ Σ\) beliebig sind, so ist \(G\) in Chomsky-Normalform.
Theorem 6.3.2
Jede kontextfreie Sprache kann durch eine Grammatik in Chomsky-Normalform erzeugt werden.
CNF-Umwandlungsalgorithmus
- Eliminierung von Terminalen in langen Regeln \(A → abBc\):
Führe für jede Regel mit mehreren Terminalen, ersetze diese terminale durch neue Nichtterminale \(T_a → a, T_b → b, T_c → c\) und ersetze so die Regel \(A → abBc\) durch \(A → T_aT_bBT_c\).
- Eliminierung von Kettenregeln \(A_1 → A_2 → B_1B_2\):
Führe für jede Regel \(A_1 → A_2, ..., A_{k-1} → A_k\) und
- \(A_k → B_1...B_m\) mit \(m ≥ 2\) die Regeln \(A_l → B_1...B_m\) mit \(l < k\) zu \(R\) hinzu
- \(A_k → a\) die Regeln \(A_l → a\) mit \(l < k\) zu \(R\) hinzu
und entferne die Regeln \(A_1 → A_2, ..., A_{k-1} → A_k\), bis keine Kettenregeln mehr vorhanden sind.
- Binarisierung von langen Regeln \(A → B_1B_2...B_k\) mit \(k ≥ 3\):
Führe für jede Regel \(A → B_1B_2...B_k\) mit \(k ≥ 3\) neue Nichtterminale \(A_1, ..., A_{k-2}\) ein und ersetze die Regel durch die Regeln: \[ \begin{aligned} A &→ B_1A_1 \\ A_1 &→ B_2A_2 \\ A_2 &→ B_3A_3 \\ &... \\ A_{k-2} &→ B_{k-1}B_k \end{aligned} \]
Beispiel:
Gegeben sei die Grammatik \(G = (\{a,b\}, \{S,A,B\}, S, R)\) mit: \[ \begin{aligned} S &→ aAb \\ A &→ aA \mid b \mid B \\ B &→ bB \mid b \end{aligned} \]
Schritt 1 — Terminale in langen Regeln ersetzen:
Neue Nichtterminale: \(T_a → a\), \(T_b → b\).
- \(S → aAb\) wird zu \(S → T_aAT_b\) (da \(k=3\) und \(a,b ∈ Σ\))
- \(A → aA\) wird zu \(A → T_aA\) (da \(k=2\) und \(a ∈ Σ\))
- \(B → bB\) wird zu \(B → T_bB\) (da \(k=2\) und \(b ∈ Σ\))
- \(A → b\) und \(B → b\) bleiben (Einzelterminale, \(k=1\))
\[ \begin{aligned} S &→ T_aAT_b \\ A &→ T_aA \mid b \mid B \\ B &→ T_bB \mid b \\ T_a &→ a, \quad T_b → b \end{aligned} \]
Schritt 2 — Kettenregeln eliminieren:
Die einzige Kettenregel ist \(A → B\). \(B\) hat die Regeln \(B → T_bB\) und \(B → b\).
- Füge \(A → T_bB\) hinzu (von \(B → T_bB\), da \(m=2\))
- Füge \(A → b\) hinzu (von \(B → b\), bereits vorhanden)
- Entferne \(A → B\)
\[ \begin{aligned} S &→ T_aAT_b \\ A &→ T_aA \mid b \mid T_bB \\ B &→ T_bB \mid b \\ T_a &→ a, \quad T_b → b \end{aligned} \]
Schritt 3 — Regeln mit \(k ≥ 3\) binarisieren:
Die einzige Regel mit \(k=3\) ist \(S → T_aAT_b\). Neues Nichtterminal \(S_1\):
- \(S → T_aAT_b\) wird zu \(S → T_aS_1\) und \(S_1 → AT_b\)
Ergebnis in Chomsky-Normalform: \[ \begin{aligned} S &→ T_aS_1 \\ S_1 &→ AT_b \\ A &→ T_aA \mid T_bB \mid b \\ B &→ T_bB \mid b \\ T_a &→ a \\ T_b &→ b \end{aligned} \]
Alle Regeln haben die Form \(A → BC\) oder \(A → a\) — die Grammatik ist in CNF. ✓